title: "AgentOps 不是 MLOps:当代理进入生产时,你的监控栈会出什么问题"
source_url: "https://towardsdatascience.com/agentops-is-not-mlops-what-breaks-in-your-monitoring-stack-when-agents-go-to-production/"
author: "Towards Data Science"
excerpt: "公共早报 本文探讨了 MLOps 和 AgentOps 之间的关键差异,重点是传统监控假设如何无法捕捉代理系统的独特失效模式,例如累积错误和不一致的输出,并提出了一种新的代理轨迹检测框架。"
代理所打破的五条 MLOps 监控假设,以及哪些继承的信号现在会将失败运行误报为健康。
Mostafa Ibrahim 2026年8月31日 | 10 分钟阅读
 图片由作者提供
多年来,保持生产中模型健康意味着保持它与你发布的模型接近。你监控相对于参考窗口的漂移。你根据 SLO 跟踪延迟。你根据留出集检查准确率。一个数字变动,你就重新训练。
一旦模型开始调用工具,这就停止了工作。
业界的反应很快。Gartner 预计,到2027年底,超过40%的代理式 AI 项目将被取消,原因是成本上升、价值不明确以及风险控制不足。每个可观测性供应商现在都提供代理追踪。
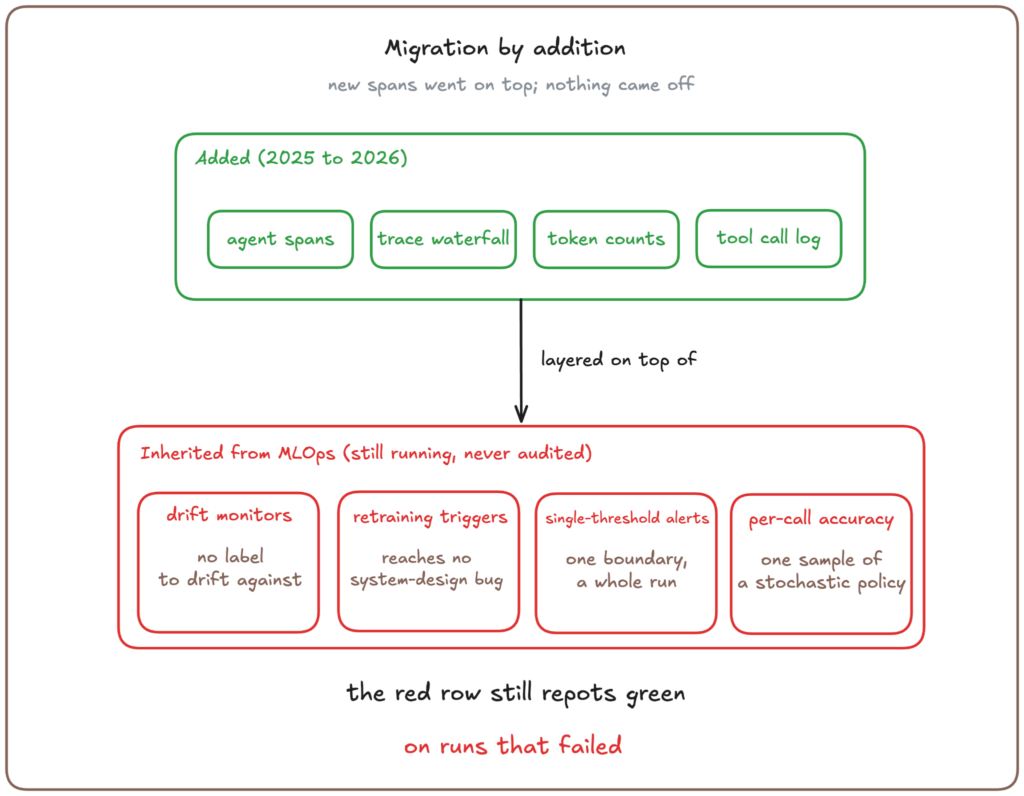
未被审视的是团队实际上如何进行迁移的。大多数人将其作为附加项来运行:旧栈之上新增 span;没有任何东西从旧栈上移除。继承的信号仍然触发,其中几个现在会在失败的运行上报告为健康。
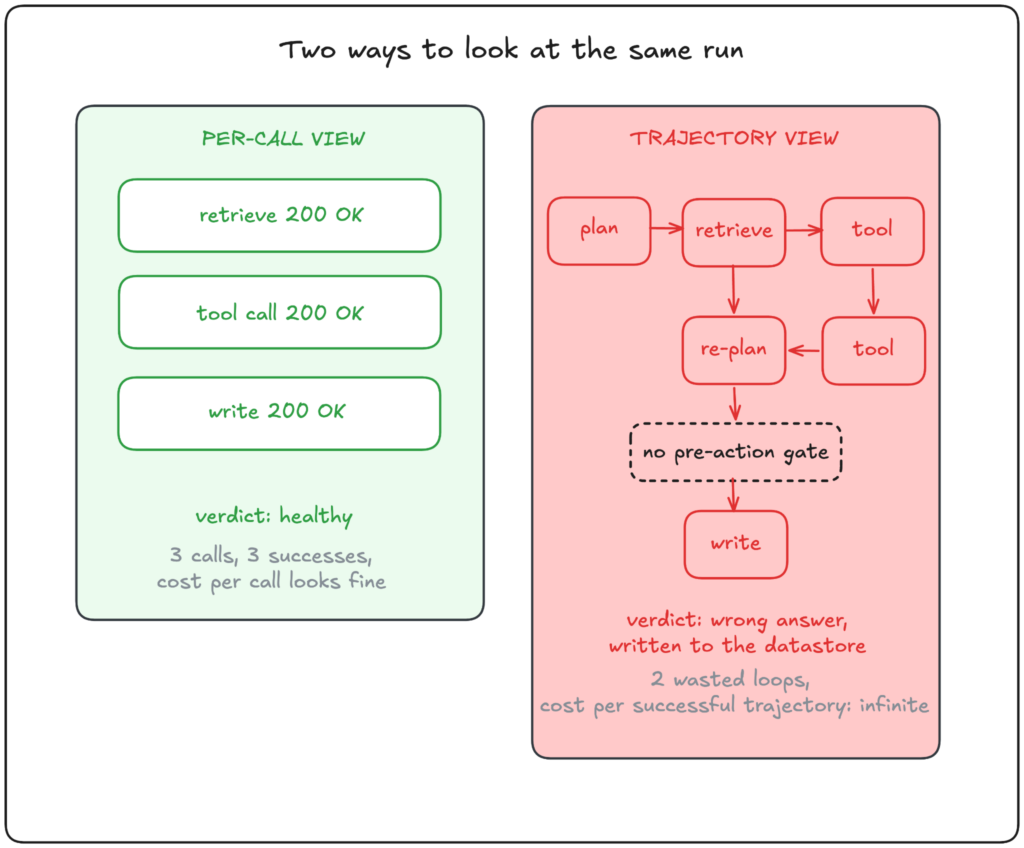
我是从一个我运行的多步骤审查管道中了解到这一点的,它展开到并行模型审阅者,并将他们的裁决写入应用数据存储。它发布的第一个错误裁决有一条完全绿色的 trace:每个 span 都成功了,延迟正常,但输出错误。
增量式迁移:没人审计的部分
 图片由作者提供
被添加进去的是真正的进步。OpenTelemetry 的 GenAI 语义约定 现在定义了代理 span:create_agent、invoke_agent、execute_tool 和 plan。该规范仍处于开发状态,在将其标准化之前值得了解。
Langfuse、LangSmith、Arize Phoenix、W&B Weave 和 AgentOps 都发出某种版本的追踪,所以你得到了一个运行的瀑布:哪个工具触发了,它返回了什么,花费了多少。
从未被重新审视的是它下面的一切。漂移监控器继续运行。重新训练触发器保持其旧的阈值不动。告警从未超越单一边界。这些组件编码的假设对于无状态评分服务成立,而对于运行循环的系统则不再成立。
五条假设承载了大部分重量:
运行之间的输出是可比较的。 相同的输入,大致相同的输出,所以差异意味着某些事情。
推理是无状态的。 请求是工作单元;没有任何东西会传递过去。
一个请求跨越一个决策边界。 有一个单一的地方来设置阈值。
真实标签会到来。 标签最终会出现以进行评分。
在模型和结果之间有一个人。 模型推荐;一个人采取行动。
一旦模型运行循环,每个假设都会以不同方式被打破,而失败通常对为其构建的信号是不可见的。监控栈通过保持绿色而失败。
五条假设,五种静默失败
这五个假设中的每一个都以自己的方式被打破,而失败通常对为其构建的精确系统是不可见的。
可比较的输出:当同一输入在同一周内通过和失败
让你的代理两次处理同一个工单。周一它给客户退款并结案;周四它在客户已经提供的订单号上循环。
Tau-bench 用 pass^k 来衡量这个:同一任务的所有 k 次尝试都成功的概率。单次 gpt-4o 尝试在零售任务中清除了大约 61%,但将同一任务运行 8 次,所有 8 次都成功的概率降至 25% 以下。用每次输入一次运行来对你的代理评分,你的仪表板报告的可靠性是你用户实际获得的 2.4 倍。
无状态推理:当路径是缺陷而答案看起来没问题时
快递员在第一站听错了街道名。之后每一步都是完美的,每一步都是错的。
代理系统的失败方式相同。Anthropic 自己的多代理研究系统直接遇到了这种模式:"一步失败可能导致代理探索完全不同的轨迹。" 每一步的输出都会输入下一步,所以早期错误不会被纠正;它会累积。
这不是一个罕见的边缘案例。MAST 分类法 将超过 1600 条追踪分类为 14 种失败模式,最大的单一类别是系统设计:错误融入到步骤如何连接的方式中,而不是任何单独步骤的输出中。重新训练模型无法修复它,因为缺陷从来不在模型中。它在路径中。
一个决策边界:当每步85%在十步时是一枚硬币抛掷
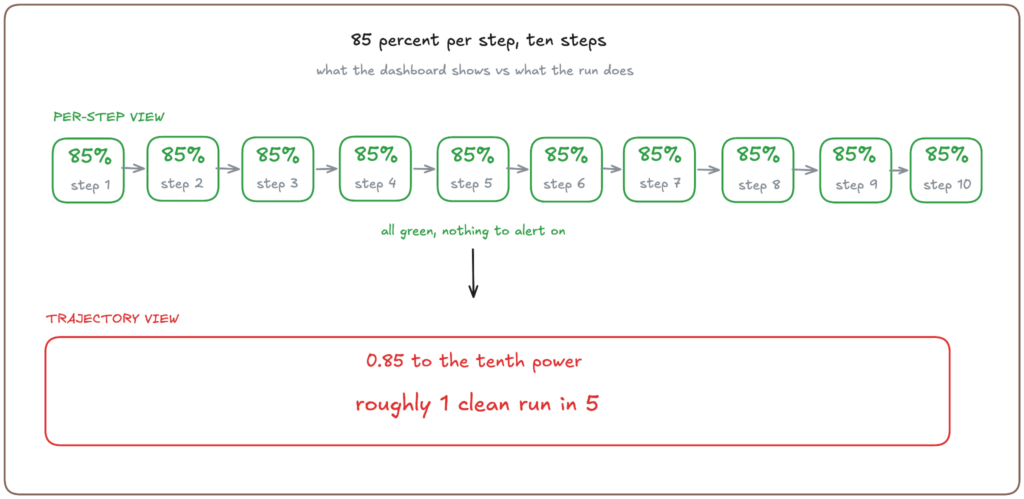
单一阈值假设了一个单一的放置位置。但十步运行只有每步都成功才会成功,概率相乘。假设每步成功率为 85%,在任何你构建的仪表板上都是健康的:运行十步,0.85^10 约为 20%。五次中只有一次干净运行。
每步监控从不相乘。它报告 85;你的用户经历 20。
 图片由作者提供
真实标签到来:当标签在实际操作之后才到达时
你的代理提交了一张工单,更新了一条 CRM 记录,并起草了一条回复。人类在周四阅读了回复;CRM 记录未被阅读。
传统监控将模型输出与"真实"标签进行比较以检查它是否正确,但该标签必须来自某处。当输出是预测时,人类可以快速标记它。当输出是一个行动时,唯一真正的判断者是数天后检查结果的人类,或者根本不检查。
所以团队用廉价的自动验证器代替:一个检查输出的脚本,而不是一个人。MAST 发现 "许多现有验证器只进行表面检查",比如确认代码编译而不是确认它正确。一个 ChatDev 构建的国际象棋程序通过了所有这些检查,仍然在运行时出现 bug,并在 ProgramDev 基准测试中只得了 25 分。
中间有人:当唯一见证行动的是 trace
这个假设代价高昂,因为代理不只是预测;它采取行动。移除人类,trace(代理做了什么日志)成为行动是否正确的唯一证据。
但 trace 可能是假的,甚至是偶然的。一个 CrewAI issue 记录了代理写出虚假但令人信服的序列:'我运行了工具,这是它返回的',而工具实际上从未运行。模型只是生成了看起来像真实工具调用和结果的文本。本机工具调用(由系统而不是模型执行行动)避免了这个特定的 bug。但更深层的问题仍然存在:我的管道 trace 完全绿色,它是关于仍然做错了的工作的准确遥测。
用什么替代它们:检测轨迹
退役一个信号比添加一个更难。以下是值得工作的映射。
|-------------------------|--------------------------------------|------------------------------------------------------|-----------------------------------------| | 假设 | 编码它的信号 | 该信号看不到什么 | 应该检测什么 | | 输出可比较 | 单次采样运行上的每调用准确率 | 相同输入上的运行间不一致性 | 跨重复试验的 pass^k | | 推理是无状态的 | 请求级成功率和延迟 | 仍然返回干净的路径中的缺陷 | 带步级状态的轨迹回放 | | 一个决策边界 | 每步成功率 | 整个路径上累积的失败 | 轨迹完成率 | | 真实标签到来 | 相对于参考窗口的漂移 | 改变策略而数据没有变化的提示编辑 | 版本化的代理配置,每次运行 diff | | 中间有人坐着 | 单阈值告警 | 在评分良好的运行内不安全行动 | 每个副作用上的行动前门 |
每次成功轨迹的成本。 消耗 40 个工具调用然后失败的运行比消耗 12 个调用然后成功的运行花费更多,而每调用仪表板将它们排名相反,因为它们对调用评分,而不是对结果评分。多代理系统已经使用大约 15 倍于聊天交互的 token,所以分母是金钱藏身之处。
硬上限而不是递归限制。 大多数框架让代理在假设每次重试都是进步的情况下重试高达固定递归限制,通常高达 20。一位评论者在 LangGraph issue 上描述了一个代理循环到其递归限制,同时"整个时间都在燃烧 token,对发生的事情没有可见性"。
那不是进步;代理不断遇到相同的确定性工具错误,它没有办法推理过去,每次重试只是重新生成一个几乎相同的调用。硬上限修复了递归限制无法修复的问题:它在重试不再看起来像进步时就标记一个运行,而不是等待计数用完。一位从业者建议在 3 到 5 次相同重试后标记,而不是 20 次。
配置作为监控表面。 行为追踪记录了代理做了什么,而不是有人在一小时前编辑了一条系统提示词。那个编辑改变了策略而数据保持不变,所以每个监控数据的漂移监控器从构造上保持沉默。修复方法是将整个配置作为一个可 diff 的单元:提示词、工具、模型和参数,一起版本化,而不仅仅是孤立的提示词。
我首先会添加的检测是一个确定性预检查。我将自己的管道移到了一个在模型审阅者之前运行的预检查上;在看着他们让机械缺陷通过之后,一个正则表达式在不到一秒内解决了它。对于任何更便宜的工具可以决定的事情,模型基础评估都是错误的工具。
 图片由作者提供
当旧栈仍然是正确答案时
并非每个 LLM 系统都是代理,失去那个区别是团队为他们从未需要的轨迹基础设施付费的方式。
没有工具且没有内存的单个模型调用是一个发出文本的无状态评分服务。每个上述假设都成立。像监控模型一样监控它:输入分布、输出质量、延迟、成本。
LLMOps 对于包装器来说就够了。 如果包装器检索一次生成一次,没有循环,需要提示词版本控制和输出评估。LLMOps 涵盖这些,这就够了。追踪工具在一个两步管道上为你购买存储成本和一个无人阅读的仪表板。
最强烈的怀疑案例来自行业内部。Langfuse 联合创始人 Marc Klingen 在 2024 年 2 月的 Hacker News 上写道 "可观测性不需要被重新发明来获取应用程序 LLM 部分的详细追踪/指标/日志",将价值重新定位到提示词管理和评估上。
管道参数论点成立。 他写的是关于 LLM 应用程序,两年前代理才是问题。在管道上,他是对的。传输、span 模型、存储和采样是 OpenTelemetry,代理不需要新的有线协议。
累积不是定律。 MAKER 通过极端分解和投票将任务驱动超过一百万模型步骤而零错误,所以步骤乘法是一个工程问题,一个可解决的工程。这也是只在整个运行的层面才会出现的工程。
分析单元。 APM 询问调用是否成功,而代理在每次调用都成功时失败。MAST 的第二大类别是代理间错位,每个组件都工作,但它们之间的协调失败了。
新学科的账单。 测量 pass^k 意味着将每个任务运行 k 次。在 k 为 8 时,你的推出花费是单样本评分成本的八倍。
所以立场是有条件的,这部分是我的判断。如果你的代理是只读的而人类阅读每个输出,旧栈加 span 级追踪目前还能应对。如果它写东西,或者如果运行通常在返回之前超过五个工具调用,你就必须开始测量轨迹。
决策框架:购买追踪供应商前要问的两个问题
两个问题解决大多数情况。
系统是否在决策与其结果之间没有人参与的情况下做决定? 如果一个人在每个输出被处理之前都审查它,你的爆炸半径是有界的,输出级监控覆盖了大部分风险。
它的决策是否产生外部副作用? 对数据存储的写入、付款、发送的消息、触发的部署。副作用将质量问题变成事件。
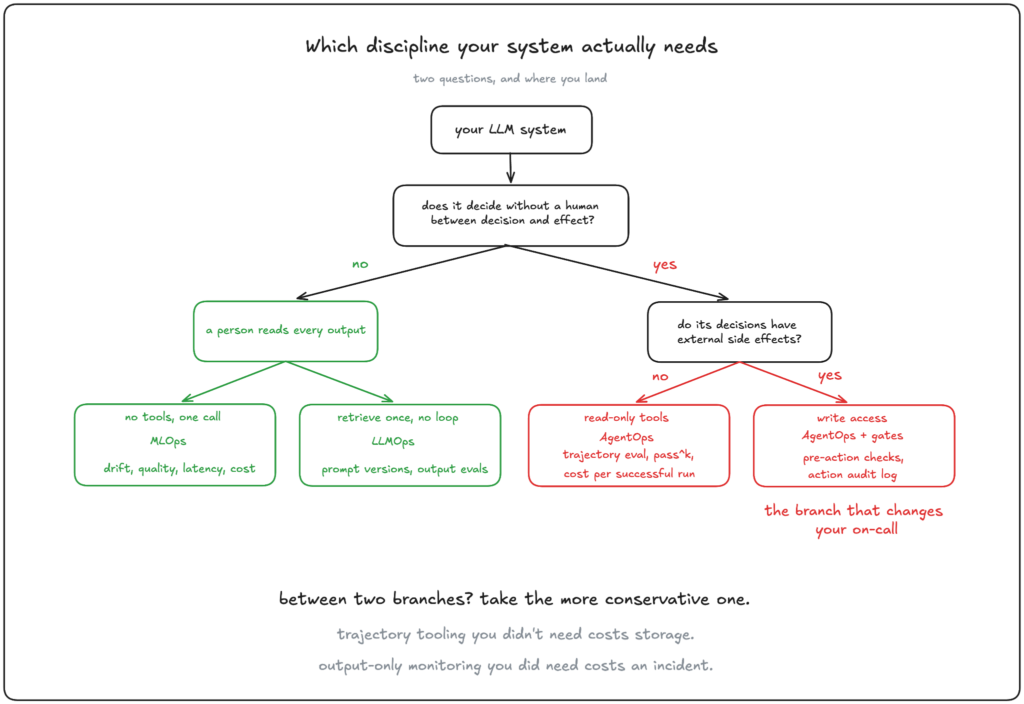 图片由作者提供
如果系统处于两个分支之间,采取更保守的那个。你不需要的轨迹检测让你付出存储成本;你需要的输出级监控让你付出在仪表板之前客户报告的事件。
结论:从会写的代理开始
朝一个方向采用而不是一次性全部。采用有写入访问权限的单个代理,检测其完整轨迹,设置硬迭代上限,并保护其副作用。将只读代理留在你已经拥有的东西上,直到第一个变得无聊。
追踪是这个迁移的廉价半部分。昂贵的半部分是决定停止信任哪些继承的信号,并在代理采取仪表板告诉你没问题的行动之前完成它。
延伸阅读
Sierra:tau-bench(pass^k 指标,代理一致性的最干净度量)。
UC Berkeley:为什么多代理 LLM 系统会失败?(MAST,最大的实证多代理失败分类法)。
Anthropic:我们如何构建多代理研究系统(状态性、累积错误和 token 倍数)。
OpenTelemetry:GenAI 代理 span(代理检测,供应商中立)。
NVIDIA:NeMo Agent Toolkit(从代理级别到 token 分析工作流)。
Gartner:超过40%的代理式 AI 项目将在2027年底前被取消(每个董事会演示文稿现在引用的预测)。
···
感谢阅读。我是 Mostafa Ibrahim,Codecontent的创始人,这是一家面向开发者的技术内容机构。我写关于代理系统、RAG 和生产 AI 的文章。如果你想保持联系或讨论本文中的想法,你可以在 LinkedIn 上找到我这里。
作者: Mostafa Ibrahim 查看所有来自 Mostafa Ibrahim 的文章 AI Agents | Machine Learning | Mlops | Observability | AgentOps 分享这篇文章
Towards Data Science 是一个社区出版物。提交你的见解以触达全球读者并通过 TDS 作者付费计划赚取收入。
为 TDS 撰稿