title: "为什么 RAG 复杂度应该被证明是必要的"
source_url: "https://towardsdatascience.com/why-rag-complexity-should-be-earned/"
author: "Towards Data Science"
excerpt: "公共早报 本文主张对 RAG 架构采取审慎的渐进式方法,建议仅在简单方法被证明不足时才添加复杂功能,例如代理式检索,这一观点得到了最近显示词汇和混合搜索表现强劲的基准测试的支持。"
一个用于构建 RAG 管道的框架,引入复杂度以响应观察到的失败模式,从词汇和混合搜索到重排序和代理式信息搜索
Tahreem Rasul 2026年8月31日 | 19 分钟阅读
检索增强生成(RAG)架构在过去几年已大大扩展,超越了原始的检索并生成模式。当代系统越来越多地整合密集检索和词汇检索、查询重写、排名融合、神经重排序、问题分解、纠正检索、反思和基于代理的编排。这些技术可以显著提高复杂信息搜索任务的性能。然而,它们也经常在底层检索子系统尚未被独立评估之前就被采用。
本文探讨 RAG 复杂度应该如何根据测量的检索失败模式引入,而不是作为架构默认值采用。最近的研究表明,比较常规的检索方法仍然具有很强的竞争力:词汇检索在专业领域表现良好,带重排序的混合检索提供可靠的基线,而且即使代理系统在其上构建更强检索时也表现更好。
这并不意味着代理式 RAG 不必要。相反,检索质量和代理推理解决不同部分的问题:当证据可以通过明确定义的检索步骤恢复时,主要关注通常是搜索质量;当检索是迭代的、多跳的或依赖于中间证据时,代理式检索变得更加有用。
RAG 架构中增长的复杂度
以下是新 RAG 系统中日渐常见的模式:
出现了一个检索问题。在确定检索本身是否正常运行之前,架构堆积了查询重写、路由、多次检索传递、反思、纠正检索、一个代理决定是否需要额外证据、一个重排序模型,有时还有一个负责验证最终答案的模型。
resulting architecture 看起来很复杂。然而,系统可能仍因更简单的原因失败:相关证据被排在候选集之外,从未进入模型的上下文。这 distinction 很重要,因为检索和推理代表不同的系统能力。
如果主要失败是:
所需证据未被检索到。
那么在检索后进行额外推理不太可能修复根本原因。它可能反而增加延迟、token 消耗、不确定性和需要评估的组件数量。
这不是反对代理式 RAG 的论点。有些信息搜索任务确实需要规划、分解、异构源选择和迭代检索。
论点更窄:
架构复杂度应该对应一个已证明的失败模式。
当传统检索在结构上不足时,代理制是有意义的。然而,当证据已经存在于可检索单元中但未能进入上下文窗口时,更大的可能是主要问题在于搜索和检索子系统。
检索和生成作为不同的系统组件
RAG 系统执行两个概念上分离的操作:
检索: 识别可能包含回答查询所需信息的信息。
生成: 解释检索到的信息并构建适当的响应。
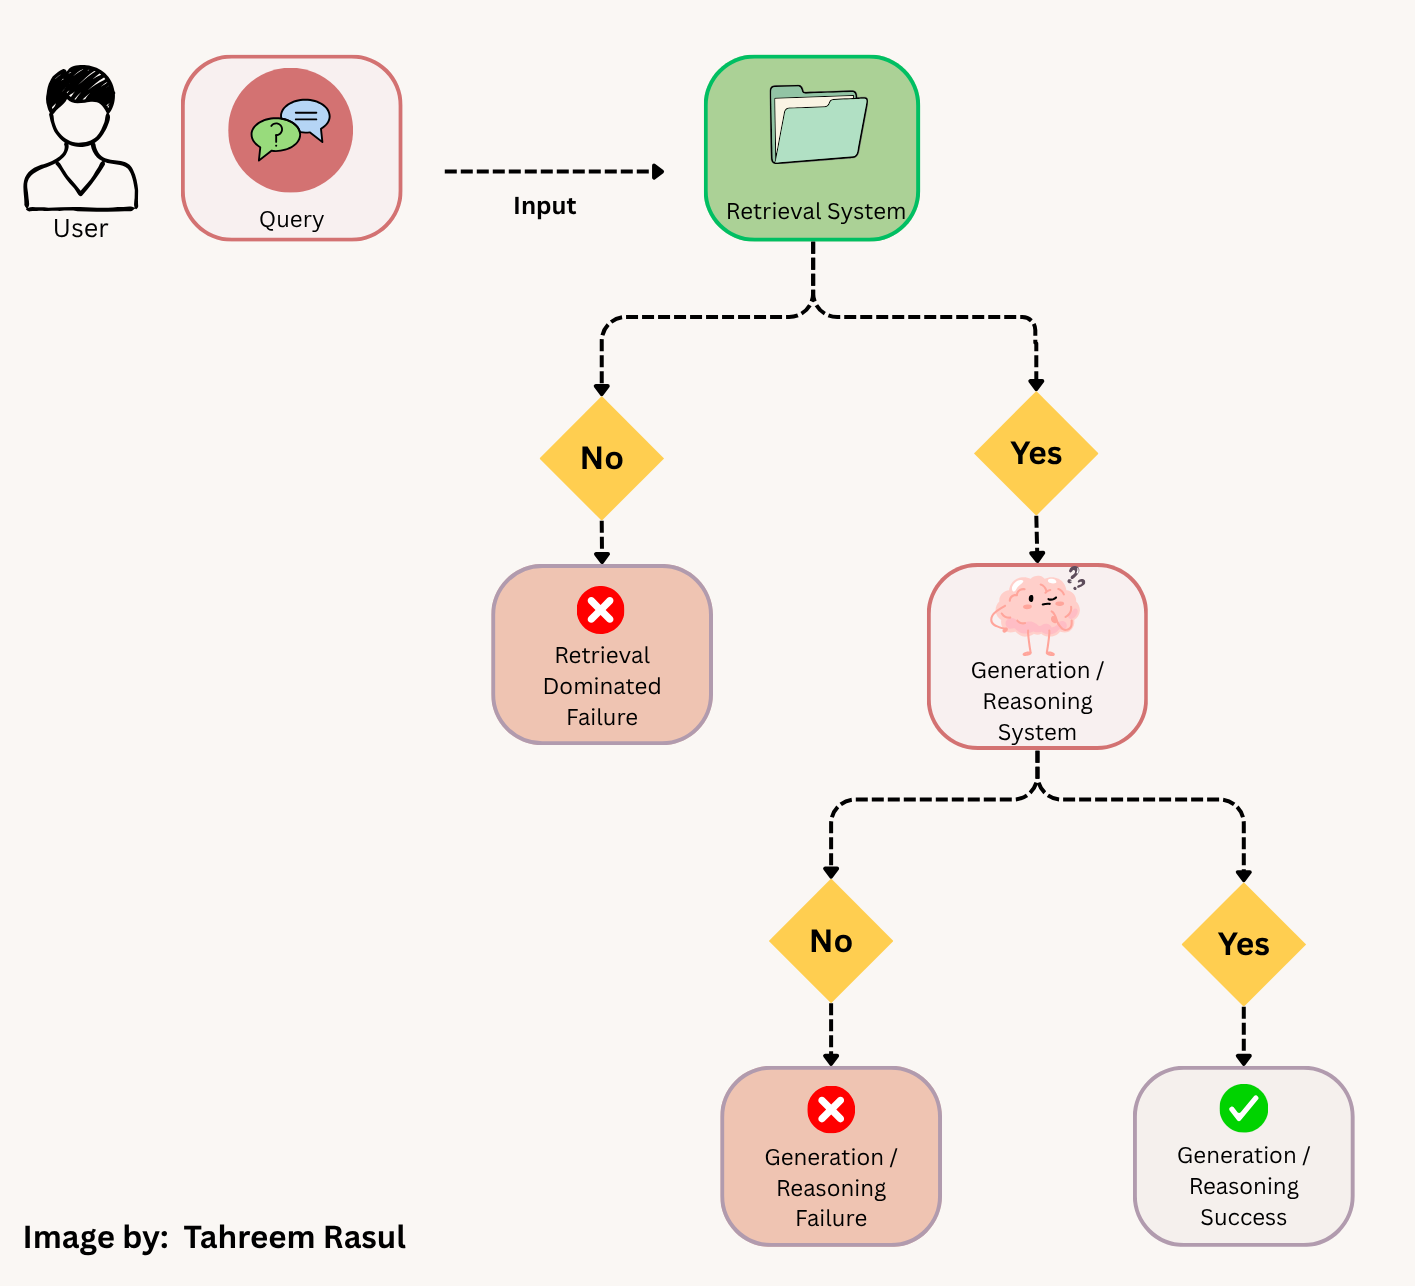
这些操作通常被一起评估,因为生成的答案是用户可见的输出。然而,从系统设计的角度来看,它们的失败模式应该分开。
考虑针对一组商业协议的查询:
如果供应商反复未能达到 SLA,适用哪些终止条款?
假设检索器返回:
描述供应商一般义务的段落,
付款条款,
包含短语 service level 的几个段落,
合同违约的定义。
然而,实际的终止条款被排在检索到的 top-k 集合之外。
足够有能力的语言模型可能仍能基于一般合同模式产生 plausible answer。它甚至可能听起来正确。系统 nevertheless failed at retrieval. 对生成提示的更改无法恢复从未进入模型上下文的证据。
这引出了一个 RAG 系统的基本诊断问题:
回答查询所需的证据是否存在于检索到的候选集中?
该问题通常应该在修改推理或生成层之前得到回答。
 图 1. 检索和生成代表不同的失败来源。端到端答案准确率 alone 无法识别哪个子系统导致了不正确的结果。图片由作者提供。
词汇检索仍然是有竞争力的基线
密集检索的广泛采用有时产生了隐含假设,即语义相似性是词汇搜索的严格继承者。 empirical evidence 并不真正支持该解释。BM25 仍然是一种非常有竞争力的检索机制,特别是在精确词汇匹配携带重要信息的领域。
其排名函数可以近似表达为:
BM25(D,Q)= ∑qi∈Q IDF(qi) f(qi,D)(k1+1) f(qi,D)+k1(1−b+b ∣D∣avgdl )
其中 f(qi, D) 表示查询词 qi 在文档 D 中的频率,而其余项 account for 诸如词频饱和度和文档长度归一化等因素。
确切公式在这里不如词汇检索和语义检索之间的区别重要。词汇搜索在查询和源共享足够匹配词汇时特别有效。密集检索在词汇重叠较弱时变得有价值。
用户可能问:
员工可以在什么情况下自愿辞职?
而底层策略只提到:
员工发起的终止。
词汇检索可能因为措辞不同而吃力。密集嵌入可以 capture that semantic relationship 并恢复相关材料。
这就是混合检索有用的地方。系统可以使用两种方法来生成候选,然后结合它们的排名,而不是在词汇和语义搜索之间选择。
代表性架构是:
 图 2. 两阶段混合架构使用廉价检索机制来最大化候选召回率,然后应用计算更昂贵的重排序器来优化精确率。图片由作者提供。
组合排名的常用方法是倒数排名融合:
RRF(d)= ∑r∈R 1 k+ rankr (d)
不是直接比较 BM25 分数和嵌入相似度分数,它们不一定在可比规模上,RRF 根据相对排名组合结果。
生成的候选池随后可以由交叉编码器或其他重排序器评估。候选生成和重排序之间的区别很重要。第一检索阶段主要负责召回率。它应该恢复足够广泛的候选集,使相关材料不太可能被丢弃。重排序器在显著更小的集合上操作,因此可以花费更多计算来估计相关性。
例如:
 图 3. 两阶段混合检索架构,结合词汇和密集候选生成、排名融合和交叉编码器重排序,然后进行上下文组装。
最近的证据支持这种方法。之前提到的 2026 年金融检索基准测试发现,最佳表现方法不是单独使用 BM25。结合混合检索和神经重排序的两阶段架构实现了 0.816 的 Recall@5 和 0.605 的 MRR@3,显著优于评估的单阶段方法。
Anthropic 在其上下文检索实验中报告了类似模式。结合上下文嵌入和上下文 BM25 将 top-20 检索失败相对减少 49%,而引入重排序将减少提高到 67%。
这些结果支持一个相对常规的结论:
检索机制经常是互补的而不是互斥的。
最新组件不一定替代较旧的。在许多情况下,最强架构来自结合它们各自的优势。
文档表示作为检索约束
到目前为止,我们谈论了检索方法。然而,检索质量部分取决于在检索查询发出之前。
解析、文档分割、元数据传播、表格处理和块构建决定了检索操作其上的单元。
考虑以下源文档: text
Section 7 --- TerminationThe customer may terminate the agreement if service availabilityfalls below 99.5% for three consecutive months.Notice must be provided within 30 days...固定 token 分割器可能产生: text
Chunk 41Section 7 --- TerminationThe customer may terminate the agreement if service availability和: text
Chunk 42falls below 99.5% for three consecutive months.Notice must be provided within 30 days...Chunk 42 仍然包含关键的事实条件,但它丢失了识别该条件所指内容所需的信息。一旦该结构在分块期间被移除,嵌入模型就无法可靠地重建它。
类似失败发生在以下情况:
标题与其部分分开,
表格标题从表格值中移除,
文档标题从块中消失,
父子关系被丢弃,
时间戳或报告期被移除,
访问控制元数据未被传播,
PDF 布局被错误地扁平化。
这使分块不仅仅是 token 管理问题。它也是信息表示问题。
Anthropic 的上下文检索实验明确解决了这个问题,方法是在索引之前向每个块 prepend 来自文档的短上下文。在其报告的实验中,上下文嵌入将 top-20 检索失败从 5.7% 减少到 3.7%。结合上下文嵌入和上下文 BM25 进一步将其减少到 2.9%,重排序将其减少到 1.9%。
更广泛的影响比具体技术更重要:
检索质量从摄取开始,而不是从查询时间开始。
在索引期间信息在结构上降级后,日益复杂的查询时间架构无法完全补偿。
代理式检索的适当角色
有些信息需求是静态检索真正不足的,这就是代理式检索有用的地方。考虑一个财务分析查询:
2025 年哪家公司有较高的营业利润率,以及每家公司将其年度变化的主要原因归因于什么?
没有单个段落 necessarily 包含完整答案。
系统可能需要:
识别 Company A 的适当报告期,
检索 Company A 的营业利润率,
检索解释变化的 management commentary,
为 Company B 重复该过程,
协调术语或报告期的差异,
比较 resulting evidence。
这里的限制不仅仅是糟糕的检索质量。信息需求本身需要多个依赖的检索步骤。
推理层可以将原始请求转换为多个检索操作: text
Q1 → Company A operating margin, 2025Q2 → Company A explanation for YoY margin change Q3 → Company B operating margin, 2025 Q4 → Company B explanation for YoY margin change
然后可以合并和重排序 resulting evidence 再生成。问题分解在这个类别的问题上有 empirical support。2025 年的一项研究评估了一个基于 LLM 的分解和重排序管道,在 MultiHop-RAG 和 HotpotQA 上报告了相对于标准 RAG 基线在 MRR@10 上提高 36.7% 和在答案 F1 上提高 11.6%。
这是添加额外推理的适当用例,因为 failure 源于信息需求的结构。
代理式检索的其他可辩护用例包括:
异构源选择
系统可能需要确定请求的信息属于:
关系数据库,
文档索引,
知识图谱,
内部 API,
代码仓库,
或外部搜索源。
在这些情况下,系统必须首先决定从哪里检索,然后才能决定检索什么。
依赖证据的检索
无法制定下一个查询直到观察到中间结果。 text
Retrieve entity
↓
Identify related entity ↓ Construct second query ↓ Retrieve supporting evidence
固定管道不太适合这种分支搜索,因为检索路径在执行期间出现。
歧义解决
初始搜索可能显示多个 plausible query 解释。然后可能需要额外检索来解决歧义、缩小搜索空间或确定是否需要澄清。
多跳证据聚合
有些问题只能通过组合分布在多个文档或系统中的事实来回答,其中需要一个中间事实来定位下一个。
在所有这些情况下,代理制增加了固定检索管道可能无法清晰表达的东西:对检索过程本身的 adaptive control。
这引出了一个更有用的设计问题:
什么样的特定检索失败需要自适应推理?
这个框架比将 RAG 和 代理式 RAG 视为竞争架构类别更有用。在某些情况下,传统检索完全足够。在其他情况下,检索过程本身是迭代的、条件性的或多步骤的,额外复杂度由问题证明是合理的。
检索质量作为代理推理的约束
最近更有趣的结果之一表明,更强的检索可以使代理系统显著更好。2026 年一项 scaling 研究比较了 28 个嵌套语料库大小(从大约 1,000 到 512,000 个文档)的词汇、密集、基于图和代理式检索。
BM25 在每个测量规模占据帕累托 frontier 的低成本端,并从中型语料库规模开始 lead accuracy。原始文件系统代理在小规模具有竞争力,但随着语料库大小增加而显著恶化,同时消耗 substantially more query-time tokens。
然而,最 informative 结果出现在改变代理下方的检索机制时。
在完整规模:
 图 4. 结果来自 https://arxiv.org/abs/2607.26497
更强的检索层没有使代理冗余。它使代理显著更好。这个结果帮助分离经常被讨论为可互换的两种能力。检索决定什么证据变得可用于系统;推理决定如何使用该证据以及接下来应该发生什么。弱检索 substrate 限制了可用于代理的证据,而更强的证据给相同的推理层更好的后续决策基础。
因此关系更好地表示为: text
Retrieval quality
+
Adaptive reasoning ↓ Improved information seeking
而不是: text
Agentic reasoning
↓
Replacement for retrieval engineering
该研究还说明了为什么被框架为 BM25 对代理或经典 RAG 对代理式 RAG 的辩论经常在概念上无帮助,因为它们在架构的不同层次操作。
自适应检索的计算和运营成本
到目前为止,我们已经论证了当额外检索复杂度解决特定限制时可能是合理的。然而,那个架构复杂度有 inference spend 之外的成本。
相对受限的管道可能执行: text
retrieve
↓
rerank ↓ generate
自适应架构可能执行: text
classify intent
↓
construct search plan ↓ generate subqueries ↓ retrieve ↓ inspect evidence ↓ rewrite query ↓ retrieve again ↓ evaluate evidence sufficiency ↓ possibly retrieve again ↓ generate ↓ verify
后者架构引入了明显的 token 和延迟成本。更重要的是,它引入了更大的失败 surface。incorrect response 可能源于:
intent classification
query decomposition
tool selection
query rewriting
lexical retrieval
dense retrieval
fusion
reranking
evidence-sufficiency judgement
stopping criteria
generation
verification
每个自适应分支也引入额外的不确定性。运营问题因此从:
模型正确回答了吗?
变为:
产生了什么轨迹,哪个组件对失败负责?
这对可观测性有直接影响。生产代理式检索系统 increasingly require 包含的 trace: text
user query
│
├── classification
├── generated subqueries
├── retrieval candidates
├── retrieval scores
├── reranker scores
├── tool calls
├── intermediate evidence
├── agent decisions
└── final response
没有这些信息,端到端准确率的改进可能隐藏系统中其他地方的恶化。因此,更复杂的架构仅在其改进足够大以证明其额外延迟、推理成本、运营负担和失败模式合理时才被证明是合理的。
检索和生成的独立评估
端到端答案准确率不足以诊断 RAG 系统。
四种 broad outcomes 是可能的:
 图 5. 检索和生成失败模式及其解释
第三种情况尤其危险。
模型可能正确回答问题 even though the RAG system failed to retrieve supporting evidence,使用参数知识。纯答案评估可能记录 success。然而,grounded enterprise system 通常应该记录 failure。
因此,检索应该使用常规信息检索指标独立评估。
Recall@k
Recall@k 测量相关证据有多少出现在前 k 个检索项中。
Recall@k= ∣Relevant documents in top-k∣∣Relevant documents∣
对于许多 RAG 应用,recall 是关键的第一阶段指标,因为证据在生成之前被丢弃随后无法恢复。
Precision@k
Precision@k 测量检索项中有多少是相关的。
Precision@k= ∣Relevant documents in top-k∣k
高召回率伴随着非常差的精确率创造不同的失败模式:所需证据存在,但被 enough irrelevant context 以至于 degrade model performance。
Mean Reciprocal Rank
Mean Reciprocal Rank 评估第一个相关结果出现得有多早:
MRR= 1∣Q∣ ∑i=1∣Q∣ 1 ranki
一致地在位置 18 检索到正确文档的系统与将其排名第一的系统具有 materially different operating profile。
Normalized Discounted Cumulative Gain
当相关性是分级而不是二元时 nDCG 变得有用。高度相关证据出现在排名顶部比出现在较弱的证据 later receive greater value。
生成可以然后使用以下维度单独评估:
factual correctness,
completeness,
faithfulness to retrieved evidence,
citation correctness,
abstention behavior,
contradiction handling.
这种分离实现更有用的诊断。
评估数据集必须代表生产检索条件
如果评估语料库不能反映生产行为,好的指标仍然不足。真实查询包含:
拼写错误,
不完整的实体名称,
未解释的缩写,
术语不匹配,
模糊引用,
时间约束,
矛盾文档,
缺失信息,
没有答案的问题。
从干净文档和 equally clean synthetic questions 构建的评估集经常 underestimate retrieval difficulty。
因此,成熟的 RAG 评估套件应该包含多种查询类别: text
Exact lexical queriesSemantic paraphrases Multi-hop questions Ambiguous questions Temporal questions Numerical questions Adversarial distractors Unanswerable questions Access-controlled questions Noisy / malformed queries
不同的检索策略可能在不同子集上失败,单个 aggregate score 可能隐藏架构弱点。密集检索器可能在语义改写上表现良好同时在标识符上吃力;BM25 可能显示相反模式。代理式系统可能在多跳问题上表现特别好,同时在 straightforward factual lookups 上添加不必要的成本。因此,评估的目的不仅仅是识别具有最高 aggregate number 的架构。它还应该识别每个架构组件解决哪些失败模式,以及它在哪里引入新的权衡。
RAG 系统复杂度的渐进架构
更有用的 RAG 设计方法是将复杂度视为升级路径。
每个额外机制应该对应有证据表明前置架构无法充分解决重要查询类别的证据。
 图 6. RAG 系统的渐进架构。更高层级并不固有地优于较低层级;每个层级引入的能力应该对应在较低层级观察到的限制。图片由作者提供。
Level 0: 确定检索是否必要
并非每个知识基础应用都需要检索子系统。
对于足够小且稳定的语料库,直接提供源材料可能在操作上更简单。例如,Anthropic 指出低于大约 200,000 token 的知识库在某些情况下可以直接提供给模型而不是动态检索。
确切阈值取决于模型、工作负载、延迟要求和成本概况,但更广泛的架构原则仍然成立:检索应该因为应用需要它而被引入,而不是仅仅因为系统被描述为 RAG。
Level 1: 建立语料库表示
如果需要检索,下一步是确保语料库被正确表示。在检索优化之前,系统应该:
validate parsing,
preserve document hierarchy,
propagate metadata,
handle tables explicitly,
establish meaningful chunk boundaries,
preserve parent-child relationships where necessary,
在摄取期间应用访问控制元数据。
Level 2: 建立词汇基线
词汇基线提供了有用的参考点。BM25 计算成本低廉、可解释,在精确术语重要的地方特别强。
其目的不是成为最终检索架构。它建立是否后来添加产生相对于 competent conventional baseline 的可衡量改进。
Level 3: 引入密集检索
当评估显示有意义的词汇-语义不匹配时,密集检索是合理的。在这个阶段,重要的比较不仅是下游答案质量,而且是词汇和密集检索返回的候选集。
如果密集检索始终恢复词汇检索遗漏的相关证据,额外复杂度正在解决一个可衡量的失败模式。
Level 4: 引入混合检索
当词汇和密集方法展示互补召回率时,混合检索变得合理。不是选择一个方法作为默认值,系统可以结合它们各自的优势。
这通常是检索架构在更广泛查询类型上变得更健壮的阶段。
Level 5: 引入重排序
如果候选召回率已经很强但结果排序仍然弱,重排序是下一个逻辑步骤。
检索层可以保持广泛和召回导向,而更昂贵的重排序器专注于在小候选集上改进 top-k 精确率。
Level 6: 改进表示
如果失败持续,问题可能仍然在于语料库表示方式而不是检索算法本身。观察到的失败模式可能证明上下文块、父文档检索、领域特定嵌入、后期交互架构、表格特定索引或替代分割策略是合理的。
在这个阶段,问题 less about 添加另一个检索机制,more about 改进这些机制在其上操作的 information。
Level 7: 引入查询转换
当评估显示系统性查询-文档不匹配或信息需求包含多个可分离组件时,查询重写和分解变得有用。
Level 8: 引入代理式检索
代理制在检索过程本身需要自适应决策时变得合理:
在异构源之间选择,
决定接下来获取什么信息,
使用检索到的证据来制定后续搜索,
确定是否已收集 sufficient evidence,
执行可变长度多跳检索轨迹。
在这个点上,架构不是仅仅因为代理可用就添加代理。它正在引入自适应控制流,因为信息搜索问题需要它。
固定和自适应检索应该共存
这个框架的 further implication follows:并非每个发送到代理式 RAG 系统的查询都应该 necessarily invoke 代理式工作流。
生产系统反而可以区分查询类别。
 图 7. 异构 RAG 系统可以将不同信息需求路由到具有不同计算和推理需求的检索策略。
这个架构将代理式检索视为更大检索系统内的一种能力,而不是通用执行路径。
例如这样的查询:
Contract 4827 中的取消期是什么?
可能只需要词汇和元数据约束检索。
例如这样的查询:
比较上季度 SLA 违规率最高的三项服务的供应商当前合同中的取消义务。
在结构上不同。它可能需要:
查询运营数据,
识别供应商,
检索多个合同,
定位相关条款,
规范化术语,
比较证据。
对两个请求应用相同的检索编排是难以证明合理的。更健壮的系统应该根据信息需求的结构路由查询,在足够时使用更简单的检索,在任务真正需要时使用自适应检索。
复杂度应该跟随已证明的失败
核心问题不是高级 RAG 技术是否有效。其中许多显然有效。问题出现在这些机制成为架构默认值而不是对观察到的限制的响应时。
LLM 使架构增强异常容易。如果检索表现不佳,额外模型可以重写查询。如果重写的查询失败,可以引入另一次检索传递。如果候选集嘈杂,模型可以为其评分。如果证据看起来不完整,反思阶段可以发起另一次搜索。如果最终响应仍然不正确,另有一个模型可以验证它。
每个添加可能改善一些查询同时也在 pipeline earlier 隐藏缺陷。足够复杂的推理系统因此可能产生更好的端到端结果,同时使架构更难理解、评估和操作。
相关工程目标不是架构 minimalism。
它是架构 justification。
组件的存在应该可以通过可衡量的系统限制来解释:
混合检索存在,因为密集和词汇检索在目标语料库上展示互补召回率。
重排序存在,因为候选召回率足够而 top-k 精确率不足。
查询分解存在,因为多跳问题在单查询检索下系统地失败。
代理存在,因为后续检索 actions depend on 在执行期间发现的证据。
这个框架将 RAG 架构从当前流行技术的集合转换为可测试工程决策的序列。
参考文献
Anthropic. Introducing Contextual Retrieval. 2024. 检查跨多个知识领域的上下文嵌入、上下文 BM25、混合检索和重排序的实验。
Akarsu, M., Karaman, R. K., & Mierbach, C. From BM25 to Corrective RAG: Benchmarking Retrieval Strategies for Text-and-Table Documents. 2026. 跨 23,088 个金融 QA 查询和 7,318 个文档的十种检索策略基准测试。
Wang, P., Xu, B., Wang, S., et al. Which RAG Paradigm Wins at Scale? A Scaling Study of Retrieval-Augmented Generation Paradigms. 2026. 在从大约 1,000 到 512,000 个文档的语料库规模上词汇、密集、基于图和代理式检索的受控比较。
Ammann, P. J. L., Golde, J., & Akbik, A. Question Decomposition for Retrieval-Augmented Generation. 2025. 在 MultiHop-RAG 和 HotpotQA 上评估 LLM 驱动的问题分解和重排序。
···
作者: Tahreem Rasul 查看所有来自 Tahreem Rasul 的文章 Editor's Picks | Agentic Engineering | Agentic Rag | Rag | Rag Architecture 分享这篇文章