title: "从排行榜到模型档案:对用于代理式编码的 LLM 进行深度评估"
source_url: "https://blog.jetbrains.com/junie/2026/08/from-leaderboards-to-profiles/"
author: "The JetBrains Blog"
excerpt: "公共早报 本文介绍了一种全面的编码代理评估管道,它不仅分析最终结果,还分析整个执行轨迹,以揭示不同的模型行为和失败模式。"
Felix Plantenberg
Felix Plantenberg 是 JetBrains 的机器学习工程师实习生,从事改进 Junie 评估管道的工作。除此之外,他的工作延伸到卫星图像处理、数据分析和流程自动化。他构建和评估数据驱动的软件。他的背景横跨计算机科学、管理和机器学习。LinkedIn
Marco Damonte
Marco Damonte 是 Jetbrains 的机器学习科学家。他喜欢寻找难题的答案并指导初级科学家。LinkedIn
想象一下,将两个来自不同前沿实验室的 LLM 插入同一个编码代理,发现它们解决了完全相同数量的基准测试任务。如果评估在这里停止,你可能得出结论:这些模型是可以互换的,直接选择更便宜的那个。
这也是发生在我们一个私有基准测试上的情况:Claude Opus 4.7 和 Gemini 3.5 Flash 解决了相同数量的任务。但这个平局掩盖了两种非常不同的执行概况。Opus 平均使用 184 步,每次运行成本 2.79 美元,而 Gemini 平均使用 271 步但仅花费 1.24 美元。最终结果相同,但每个模型达到它的方式不同。
这种差异在用于比较编码代理的最常用指标中是看不见的,即解决率。它测量评估测试通过的任务数量,以百分比表示。虽然解决率回答了一个重要问题,即代理是否解决了任务,但它几乎没有说明解决方案是如何达到的。
像 Junie 这样的编码代理不仅仅是背后的 LLM。给定一个问题和一个仓库,Junie 让模型检查文件、搜索符号、编辑代码、运行命令和执行测试。这些可观察的动作形成了代理的轨迹。轨迹不揭示模型的私有推理,但它确实显示模型如何处理仓库。我们可以看到它是否在编辑前本地化了问题、重复了相同的搜索、测试了它的假设,并保持最终补丁 focused。
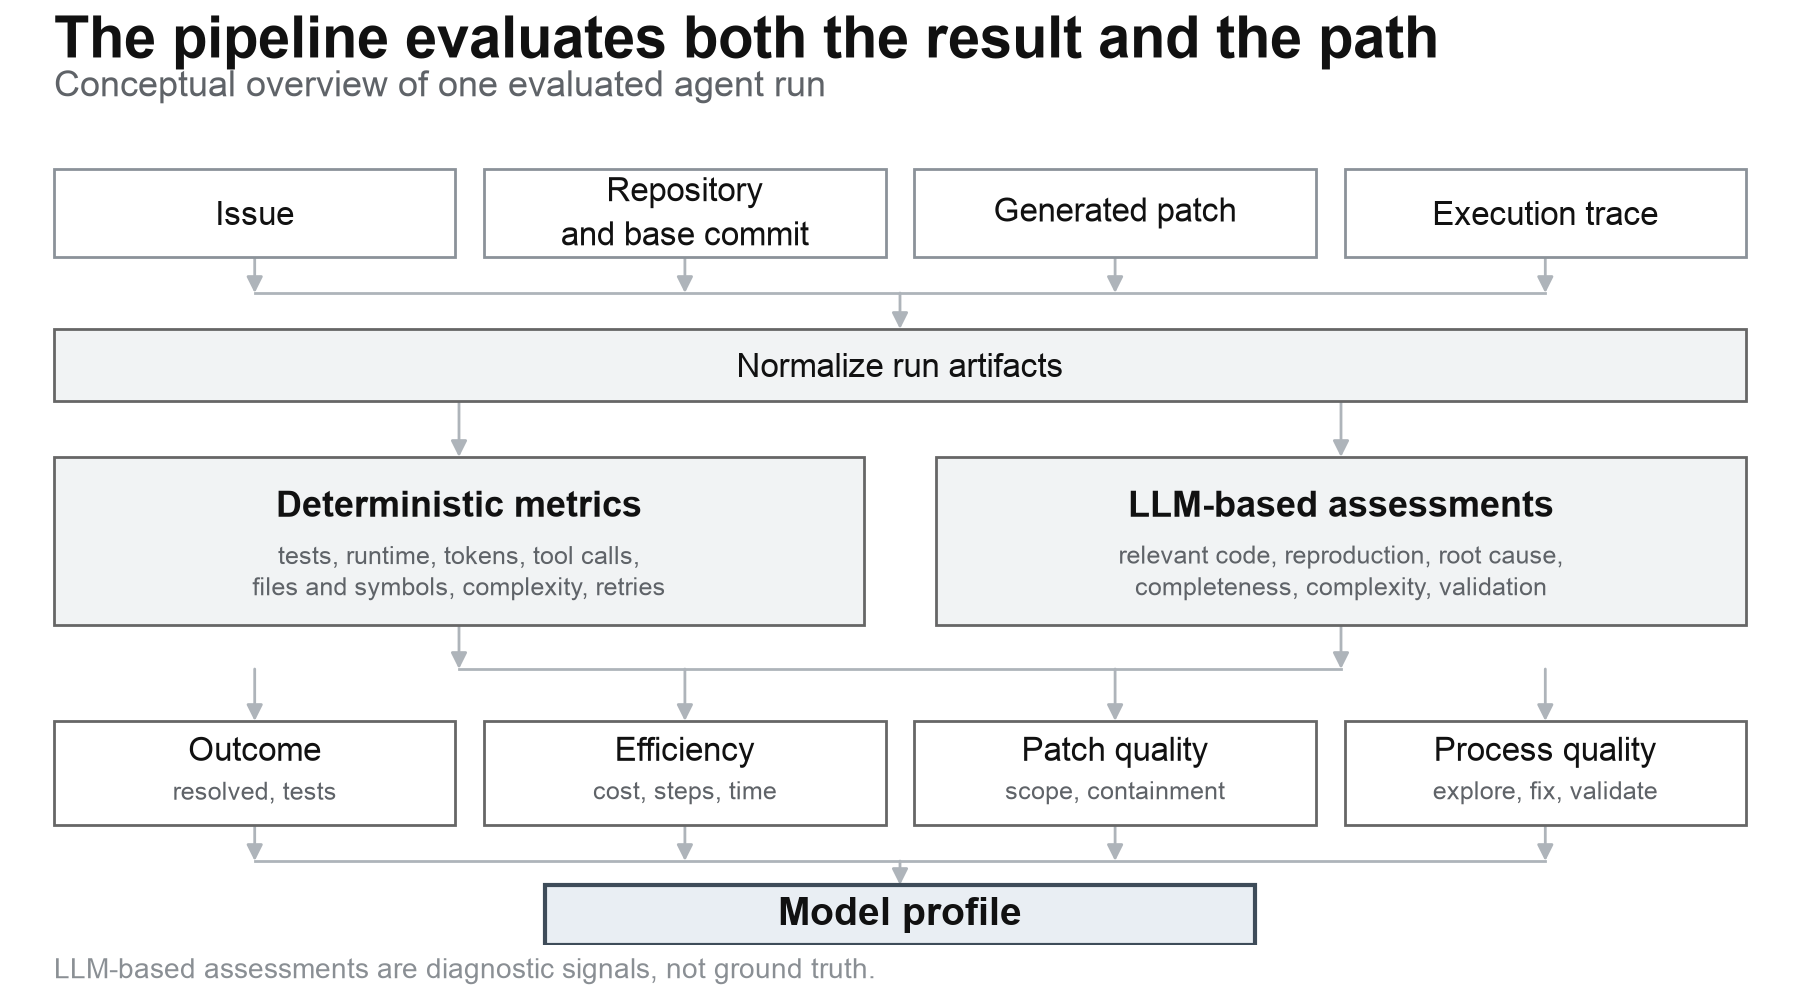
我们构建了一个评估管道,同时分析结果和产生结果的道路。它结合四个视角:功能结果、执行效率、补丁质量和过程质量。功能正确性仍然是起点,而额外指标解释了最终分数背后的内容。
最近的 JetBrains Research 帖子 描述了基准测试意义差距,在最近的研究论文中 identified:基准测试在特定设置下测量性能,但其分数经常被用作更广泛编码能力的证据。性能提升可能不会转移到其他任务,即使在同一代码库内,模型排名也可能随任务类型而变化。
我们的工作 looking at 一个相关差距在 individual agent runs 内。测试通过不能完全 describe the 补丁质量。两个补丁可能实现所需行为同时在范围、复杂度和与现有架构的契合度上差异很大。例如,一个可能改变一个相关的单一函数。另一个可能添加 helper、状态、分支或不相关的文件——仍然通过相同的测试。
失败的结果同样模糊。代理可能从未找到相关代码,可能反而误解原因,编辑错误的层,只实现部分修复,或在没有充分验证的情况下停止。这些失败都需要不同的操作。例如,重复搜索可能需要更好的仓库导航或更 focused prompting。另一个例子是对问题 correct diagnosis followed by an incomplete patch。这暗示实现或任务完成中的问题。
成本和延迟增加了另一个维度。如上所述,两个成功运行可能在 token、运行时、模型调用和工具使用上差异很大。长轨迹不一定是坏的,如果任务需要广泛调查。重要的区别是额外工作是否有助于解决方案,或者它来自重复和无用的操作。
对于模型选择,更有用的问题是哪个模型适合特定类型的任务,它在哪里花费 effort,以及它倾向于如何失败。这可以通过对我们的管道中轨迹和补丁的细粒度分析来回答。
对于每个基准测试任务,管道结合问题、仓库上下文、生成的补丁、测试结果和执行轨迹。然后它从四个角度评估运行,提出以下问题:
结果: 补丁是否解决了任务,哪些测试通过了或失败了?
效率: 运行需要多少 token、模型调用、工具调用和秒,费用是多少?
补丁质量: 更改是否触及相关文件和符号,保持 contained,并避免不必要的复杂性?
过程质量: 代理如何通过探索、实现和验证推进?它是否重现了问题,重复了工作,或在没有测试最终更改的情况下停止?
我们提出一个结合确定性指标与语义评估的管道。确定性层从日志和仓库数据派生可重现的测量。这些包括测试结果、运行时、token 使用、工具调用、修改的文件和符号、代码复杂度变化、重复文件读取、未更改命令重试和工具失败循环。
规则 alone 无法解释每个动作。打开文件两次可能是浪费,或者可能在相关编辑之后必要。 large patch 可能 unfocused,或者对于跨多个组件的更改可能是适当的。对于这些问题,LLM judges 从问题、补丁、轨迹和 bounded 仓库上下文接收结构化证据。他们评估里程碑 such as 找到相关代码、重现缺陷、识别根本原因、在补丁中解决它、引入不必要的复杂性以及验证结果。这种组合给了我们更清晰的进度 account。它不仅显示运行是否失败,还显示失败是在本地化、实现还是验证期间。下面的图片作为我们评估管道中上述组件的 illustration。
我们使用管道在包含 523 个任务的四个基准测试数据集上比较 Claude Opus 4.7 和 Gemini 3.5 Flash。结果如下所示:
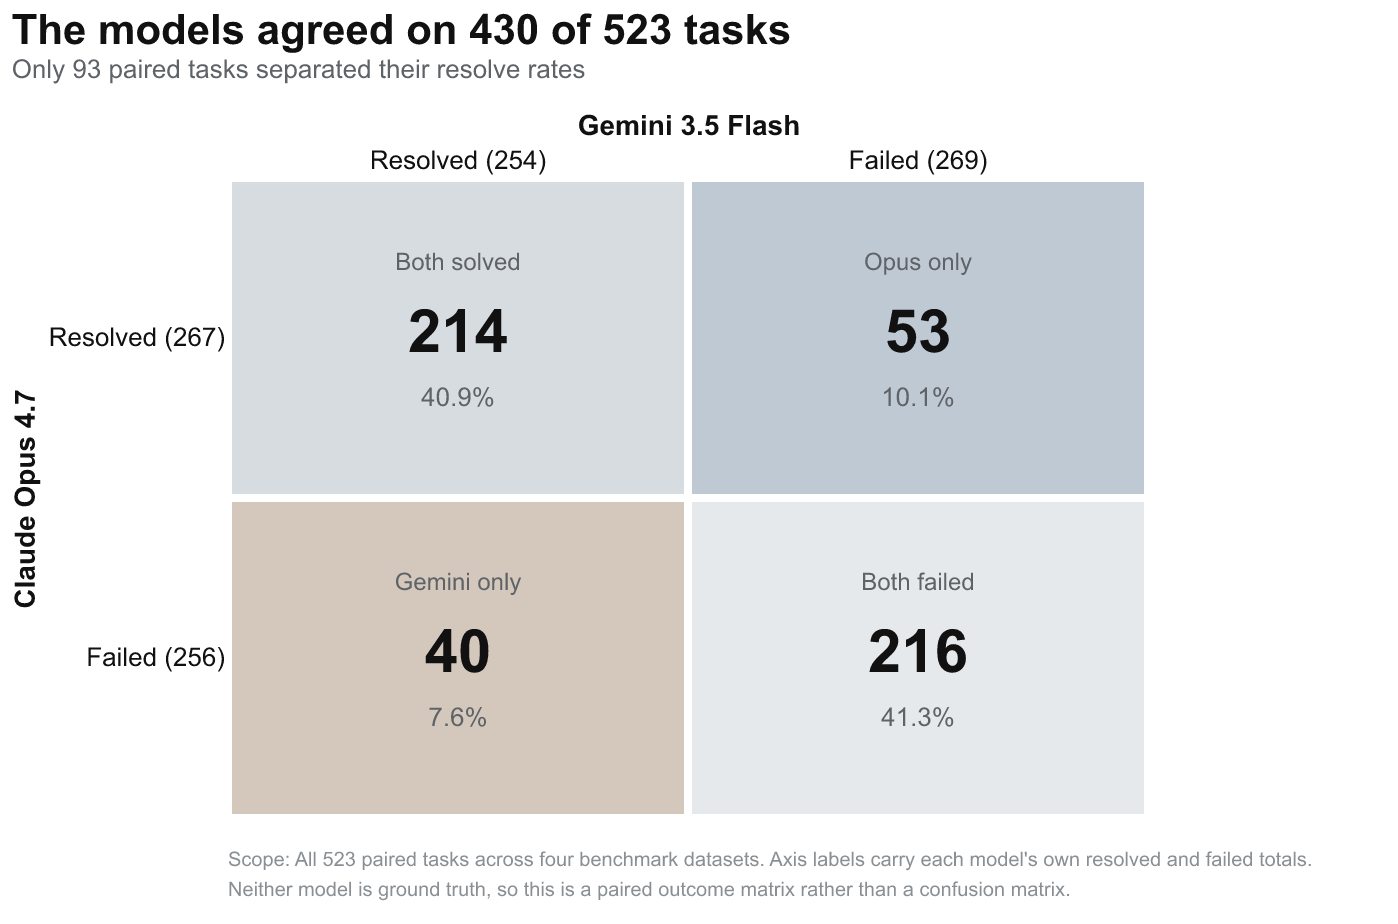
如你在上图中看到的,Claude Opus 解决了 267 个任务,或 51.1%,而 Gemini Flash 解决了 254 个,或 48.6%。模型在 430 个任务上产生了相同结果:两个都解决了 214 个,两个都失败了 216 个。只有 93 个任务区分了它们。总体分数 close,但轨迹和补丁显示了不同的行为概况。
通过不同轨迹达到的相同结果
same-task 比较使不同的行为概况具体化。一个 Opus 运行和一个 Gemini 运行都解决了同一个任务。两个 first 在第 15 步打开了一个相关文件,被判断为已识别根本原因,并执行了 thorough validation。然而,到那时它们以不同的增量进展。Opus 在文件内进行了 targeted search,并在 13 步后开始实现。Gemini 最初更广泛地检查了大模块。它在第 30 步运行了第一个可执行检查,但直到第 88 步才进行第一次生产编辑。Opus 在 53 步中完成,在探索、实现和验证之间切换了六次;Gemini 需要 192 步和三十四次这样的切换。下图描绘了不同的路径。
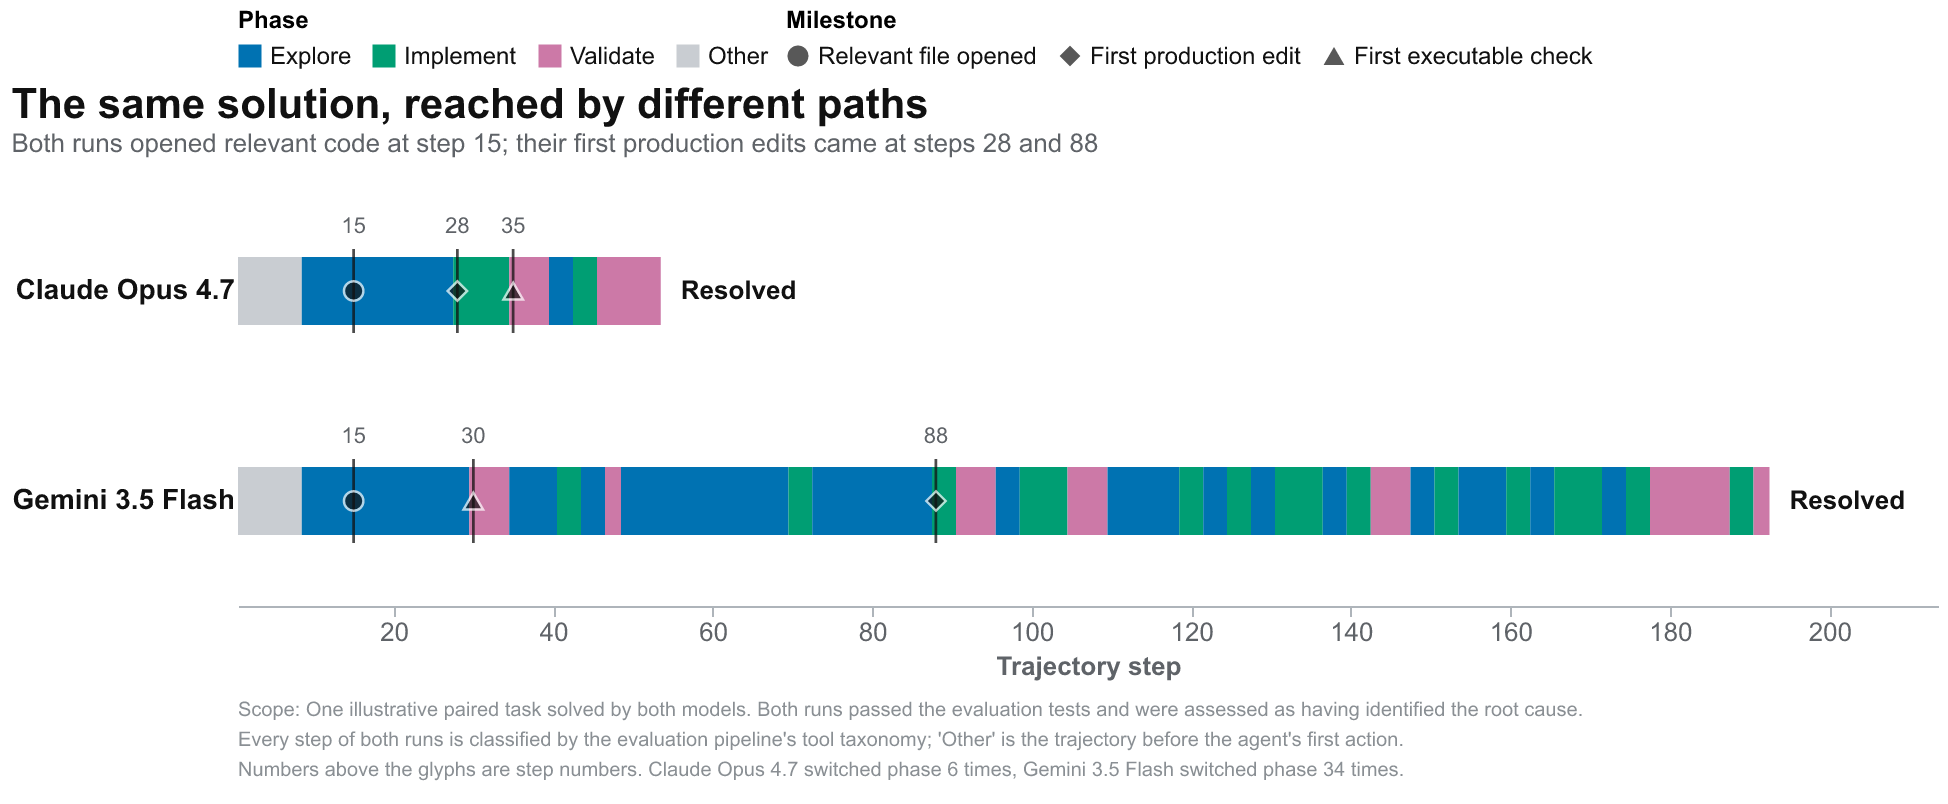
Gemini 的额外调查部分有用,但也扩大了范围并导致了未请求的更改。两个运行都通过了评估测试,都改变了参考解决方案改变了的相同文件和符号。Opus 没有触及其他任何东西。Gemini 的补丁 also reached 四个 further 文件,并在那里进行编辑。它被评估为 sprawling,具有显著冗余和 moderate hallucination。
这个单一示例是说明性的而不是统计性的。它展示了相同的基准测试成功如何可以来自直接的、contained 运行或带有不必要扩展的更长路径。
失败可能发生在多个阶段
成功的运行通常经历四个阶段:locate 相关代码,识别根本原因,实现完整修复,并验证结果。解决率将整个过程压缩为单一 binary outcome,而轨迹分析显示代理在哪里成功在哪里失败。
作为轨迹分析分离它们,我们可以更好地分析两个模型都失败的 216 个任务。我们可以在下图中看到分析结果。
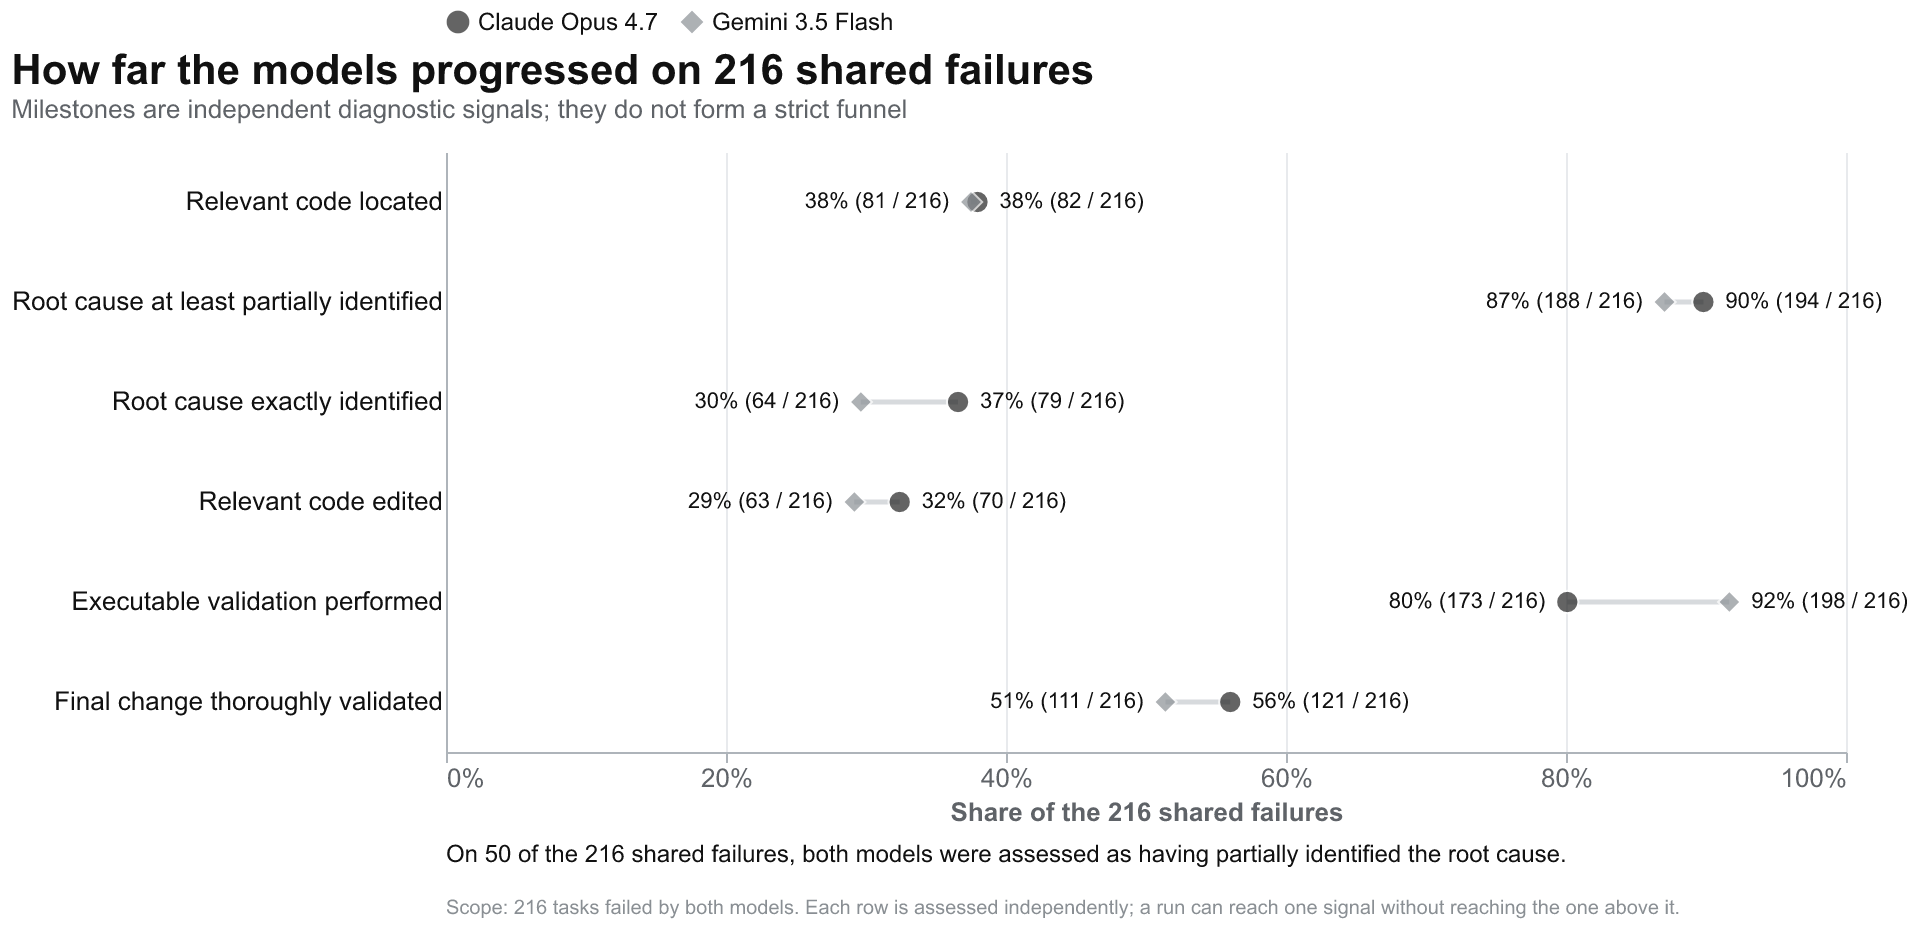
对于两个模型,超过 85% 被评估为至少部分识别了根本原因。例如,在一个任务中,两个代理都认识到超出 token 限制的文本导致了错误,但而不是将文本拆分为 valid chunks 反而截断了它。在另一个中,两个都纠正了一个代码路径中 faulty download 参数而遗漏了 companion 路径中的相同问题。二进制失败对待这些运行就像代理从未找到相关组件的情况一样,尽管它们离正确解决方案更近了。
模型并不是完全 lost。他们已经达到了相关机制但实现修复不完整,更改了错误的层,或 missed 任务的确切 contract。
这不仅仅是对照 golden patch 的问题。参考解决方案有用,但它不是唯一可能的有效实现。候选项可能更改不同的文件或架构层但仍能解决相同的机制。因此,structural comparison 需要结合诊断、完整性和验证的语义评估。
通过使用这些结果,可以构建给出更多关于它们的优势和劣势信息的模型特定概况。接下来我们列出 Claude Opus 4.7 和 Gemini 3.5 Flash 的示例概况。
Claude Opus 4.7:强诊断,较弱完成
Opus 更可能识别模糊缺陷的潜在原因。它经常达到正确的机制或架构层并解决了 Gemini 遗漏的 53 个任务。这些结果使 Opus 成为当主要挑战是理解不熟悉仓库或分离可见症状与其来源时的有用起点。
主要弱点出现在本地化之后。一些运行找到了正确机制但 stop with a reproduction test,missed a companion branch or call site,或实现了 plausible custom solution 而不是 following an existing repository pattern。在 123 次运行中,Opus 没有执行可执行验证,包括 68 次仍解决任务的运行。跳过可执行验证意味着补丁的正确性从未 actually confirmed,所以即使解决的任务也 carries undetected risk of regressions or edge-case failures 只有运行代码才会 surfaced。
总体而言,Opus 的概况表明了一个强大的诊断模型,它受益于向实现、完成和测试的明确过渡。
Gemini 3.5 Flash:更强的验证,较弱的 grounding 和收敛
Gemini 更可能运行可执行检查并使用其输出来细化解决方案。当预期行为明确时,当 responsible component 合理清晰时,当反馈 readily available 时,这些功能是有用的。
我们发现 Gemini 的主要风险是收敛和仓库 grounding。Gemini 经常在达到相关代码后继续搜索,重复等效命令,或在构建基础设施上花费许多步骤。它也更可能依赖未验证的 API、依赖项、路径或测试 fixture:它的 195 次运行,或 37.3%,被评估为包含中度或严重 hallucination,而 Opus 为 130 次运行。一些补丁超出问题范围或包含不相关的 artifacts,80 次运行,或 15.3%,显示显著或严重冗余,是 Opus 6.5% 比率的两倍多。
总体而言,Gemini 受益于精确的任务 contract、符号验证、清晰的停止规则和对 diff 的最终 review。
我们还在更广泛的模型集上运行了管道。我们在相同四个基准测试数据集上评估了 GPT-5.5、Claude Opus 4.7、Gemini 3.5 Flash 和 Qwen 3.6 27B FP8,下表比较了所有四个共享的 522 个任务。它也通过相同四个角度分离它们:GPT-5.5 达到最高解决率 51.5%,是唯一 always ran an executable check 的模型,Opus 领先每个补丁质量指标,Qwen 3.6 27B FP8 以 GPT-5.5 每次运行成本的 3% 解决了 38.9% 的任务。
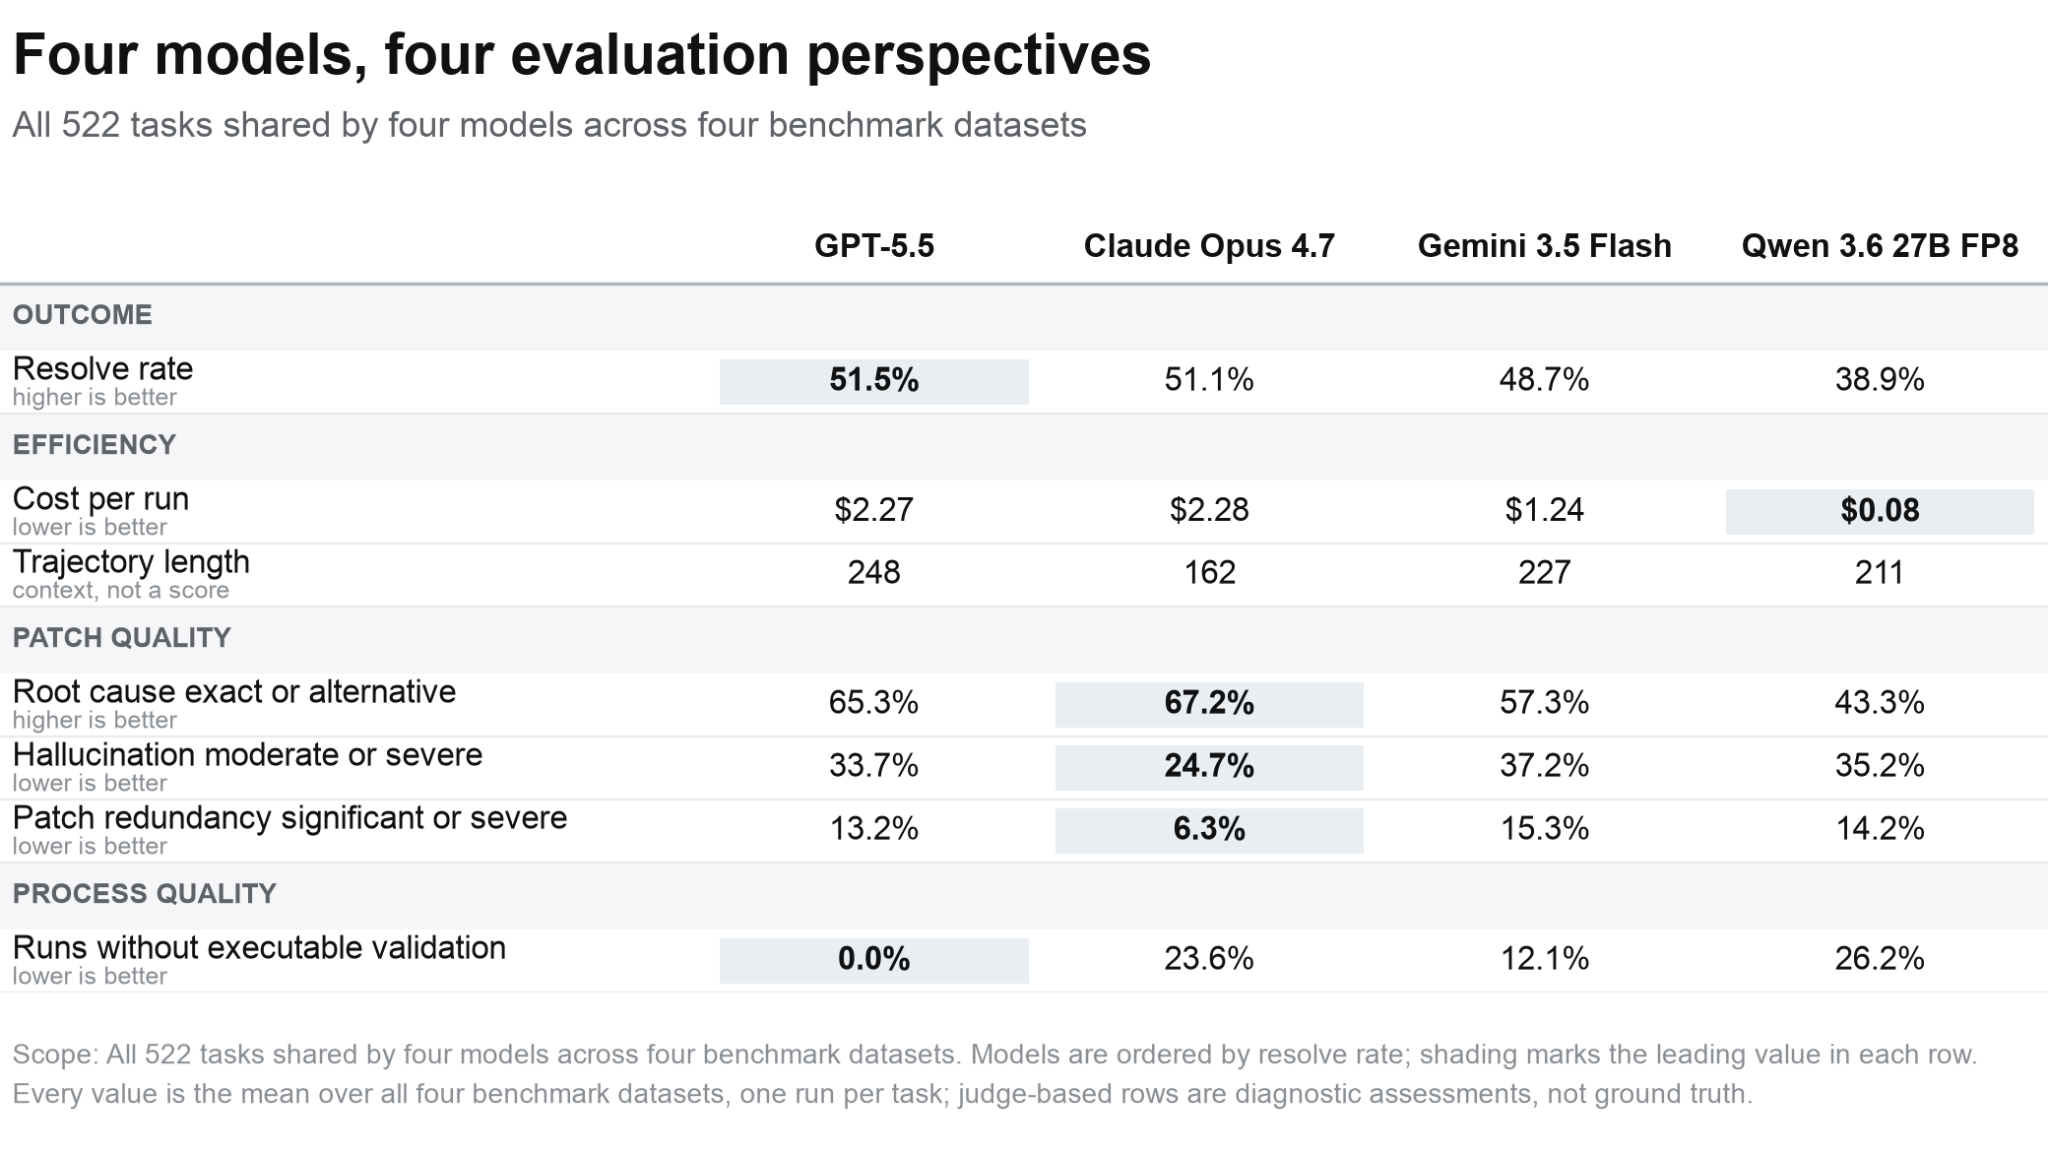
GPT-5.5 和 Opus 在解决率上相差四个百分点以内,每次运行费用相差一美分以内,所以排行榜会将它们视为可互换。但它们的补丁不是:Opus 在 24.7% 的运行中被评估为中度或严重 hallucination,而 GPT-5.5 为 33.7%,在 6.3% 的运行中被评估为显著或严重补丁冗余,而 GPT-5.5 为 13.2%,同时产生四个模型中最短的轨迹。GPT-5.5 作为回报提供的是过程纪律,因为它从未在可执行检查之外结束运行,而 Opus 在 23.6% 的运行中跳过了验证。
Qwen 3.6 27B FP8 是第三种权衡:解决率低 12.6 分,在识别根本原因方面是四个中最弱的,但便宜 enough that a failed run costs little。因此哪个模型更可取取决于昂贵的工作是诊断、补丁审查还是运行本身。
在本文中,我们为 Claude Opus 4.7 和 Gemini 3.5 Flash 推断概况。这些推断基于本评估中使用的特定 Junie scaffold,它们不应该用于一般描述模型本身。此外,LLM judge 评估是诊断信号而不是 ground truth,并且 heavily based on a single golden patch,这在大多数情况下,作为典型情况在编码领域,不是唯一可行的解决方案。因此,如果 judges 与参考方案不同,评分可能倾向于负面有效解决方案。
解决率仍然是编码代理评估的基础,但当与关于效率、补丁质量和过程的证据配对时,它变得更有用。我们的总体目标不是用另一个 aggregate score 替换排行榜。我们希望了解什么产生了每个结果,并使用这些模式来改进模型选择、prompting 和代理设计。从行业角度我们可以更好地改进代理设计,通过 move beyond aggregate success rates 到细粒度分数和行为概况。另一方面,从用户角度,我们现在可以授权 Junie 用户为工作选择正确的模型。