title: "实现病理基础模型的大规模实用化"
source_url: "https://www.microsoft.com/en-us/research/blog/gigapath-flash-and-gigatime-flash-toward-population-scale-discovery-with-efficient-pathology-foundation-models/"
author: "Microsoft Research Blog"
excerpt: "公共早报 微软研究院推出 GigaPath-Flash 和 GigaTIME-Flash,两种高效蒸馏的病理基础模型在保留大部分原始性能的同时,计算需求降低 50 倍、内存占用减少 8 倍,使大规模癌症研究成为可能。"
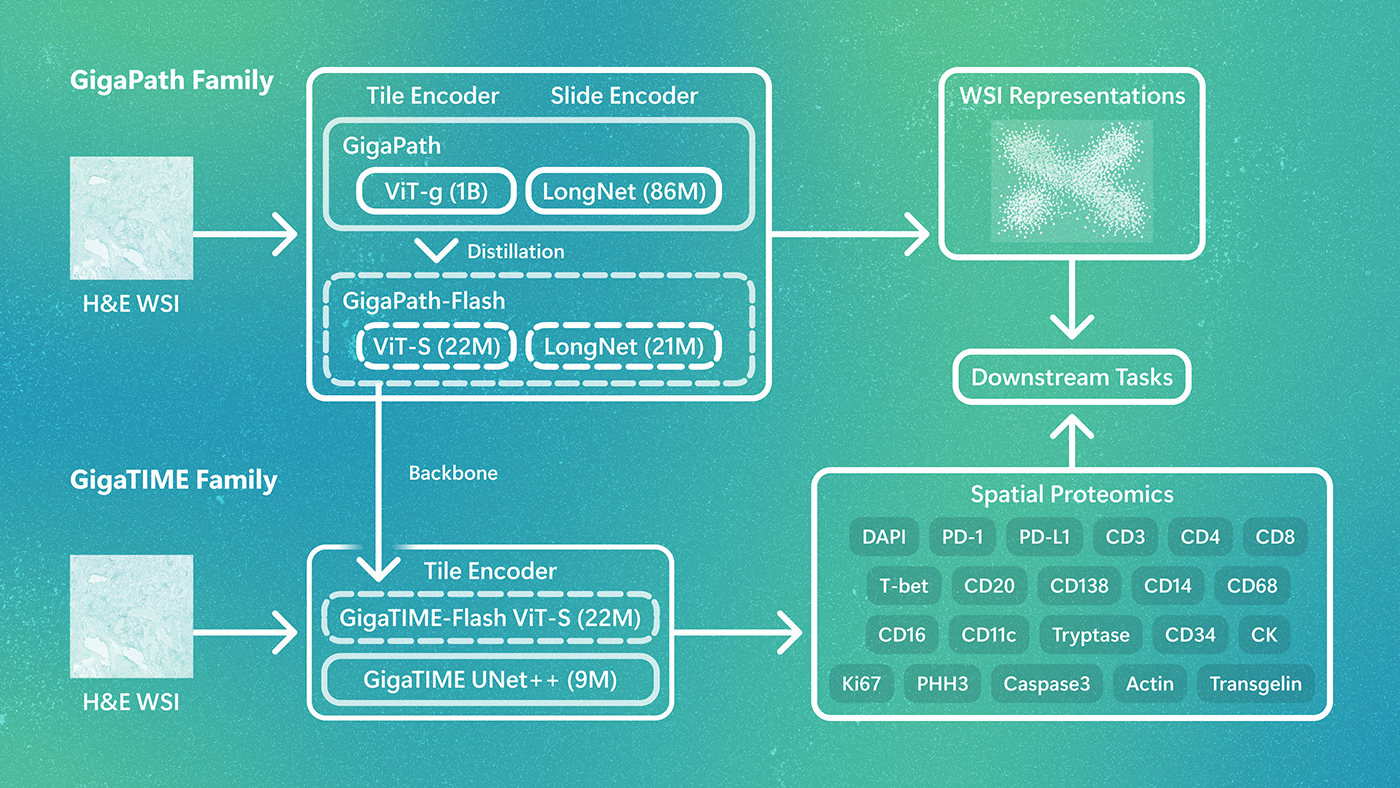
概览
Flash 系列通过显著提高的效率扩展了 GigaPath 和 GigaTIME,使大规模病理研究更容易获得和实用。
蒸馏病理基础模型主干在不牺牲性能的情况下降低了计算需求,支持在更大的患者队列中进行重复分析。
这些开放模型支持人群规模发现,帮助研究人员跨多样化癌症数据集研究疾病生物学、生物标志物和临床结果。
GigaPath 和 GigaTIME 展示了基础模型如何支持从常规收集的病理数据进行全切片分析和肿瘤微环境建模。GigaPath-Flash 和 GigaTIME-Flash 使这些能力显著更高效,使研究人员能够分析更大的队列、运行更多实验,并向人群规模发现迈进。GigaPath-Flash 和 GigaTIME-Flash 是研究模型。它们不意图或验证用于临床使用,包括诊断、预后、治疗选择或其他患者护理决定。性能可能因数据集、扫描仪、机构、人群和使用案例而异。
计算病理学中的规模机会
组织病理学是癌症研究中最丰富和最广泛可用的信息来源之一。每个组织活检产生一个全切片图像,以亚细胞分辨率 capture cellular morphology——医院每年生成数百万张这样的切片。这些数据包含与诊断、预后、治疗选择和肿瘤微环境生物学相关的信息。
基础模型已开始大规模解锁这些信息。但全切片图像很大——经常超过十亿像素——即使对单个切片应用基础模型也需要处理数千个图像 tile。当研究问题涉及数万名患者时,计算成本迅速增长。而且人群规模发现不是单一的模型运行:它需要特征提取、统计分析、假设检验和跨患者亚组、生物标志物和临床终点的验证的重复循环。
计算成本限制了研究人员可以研究的患者、数据集、任务和假设的数量。为了实现病理基础模型的全部潜力,我们需要能够在大规模患者群体中重复且负担得起地应用的模型。
从 GigaPath 和 GigaTIME 到 -Flash 系列
GigaPath(Nature,2024) 是一个全切片基础模型,在来自 Providence 的大规模真实世界组织病理学数据上预训练。与仅在 tile 级别操作的模型不同,GigaPath 学习整个切片的上下文表示,同时捕获局部细胞模式和全局组织架构。
GigaTIME(Cell,2026) 将这项工作扩展到肿瘤微环境。在 4000 万个带有配对 H&E 和 multiplex immunofluorescence(mIF)数据的细胞上训练,GigaTIME 将常规 H&E 图像转换为跨 21 个蛋白质通道的虚拟空间蛋白质组图谱。应用于超过 14,000 名癌症患者,它生成的人群揭示了超过 1,200 个免疫细胞状态与临床生物标志物之间具有统计学意义的关联。
GigaPath 和 GigaTIME 解决了病理数据的规模和生物学发现规模问题。现在,Flash 模型系列解决了实验规模问题。
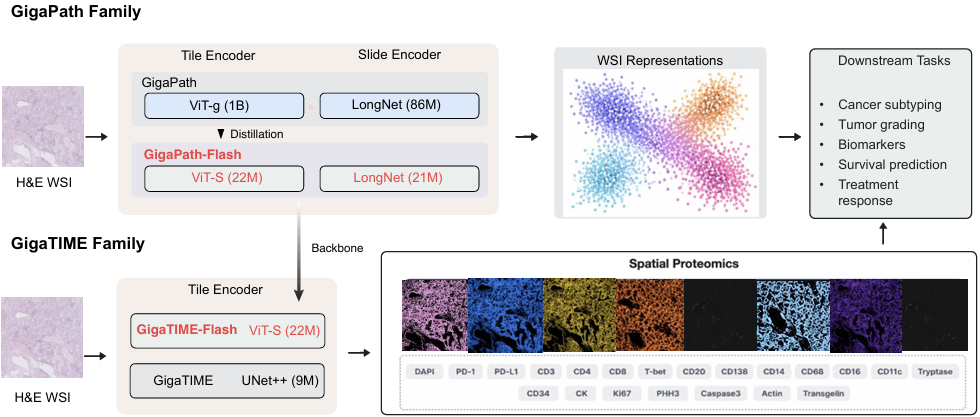 图 1:GigaPath/GigaTIME 模型系列概述。GigaPath-Flash 提供高效的 22M 参数 tile 和 slide 编码器。GigaTIME-Flash 从 H&E 预测空间蛋白质组,用蒸馏 ViT-S 编码器替换 CNN 主干。
介绍 GigaPath-Flash 和 GigaTIME-Flash
Flash 系列共享一个核心设计目标:在显著减少生成和使用它们所需的计算资源的同时,保持有用的病理表示。两个模型都建立在通用高效主干之上——一个从原始十亿参数 GigaPath 编码器蒸馏的紧凑 ViT-S tile 编码器——并且都在 Apache 2.0 许可证下发布。
GigaPath-Flash
GigaPath-Flash 是一个用于全切片表示学习的高效基础模型。它结合了一个 22M 参数 ViT-S tile 编码器和一个 21M 参数 LongNet slide 编码器。tile 编码器从原始 GigaPath ViT-g teacher 蒸馏,将十亿参数模型的表示能力 transfer into 一个 order of magnitude 更小的主干。slide 编码器通过扩展注意力 contextualizes 所有 tile embeddings,with the number of tiles 线性扩展。
在切片级分类基准测试(PANDA 前列腺分级和 EBRAINS 脑肿瘤亚型分类)上,GigaPath-Flash 在全切片预训练模型中实现了最低推理成本,同时保持竞争性能——以大约 50 倍更少的计算量得分 within 3% 的原始 GigaPath。
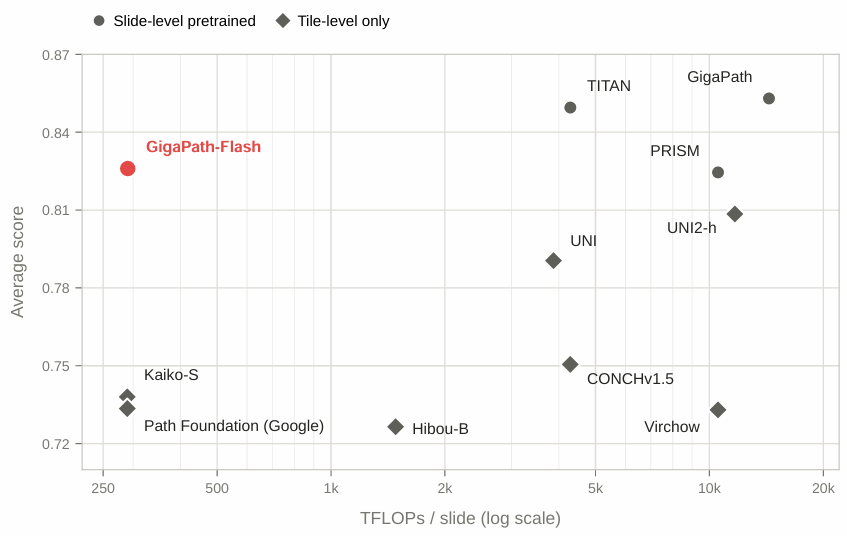 图 2:效率-性能权衡在全切片基准测试上。GigaPath-Flash(红色,左上角)以显著更低计算成本实现竞争性能。
GigaTIME-Flash
GigaTIME-Flash 用 GigaPath-Flash ViT-S 编码器替换了原始 GigaTIME 的 CNN 主干,与用于 H&E 到 mIF 转换的轻量级卷积解码器配对。该模型使用 LoRA adapters 进行微调,保持预训练编码器权重 largely frozen。
在涵盖脑、乳腺、结肠和肺癌的分布内和分布外队列上,GigaTIME-Flash 在空间蛋白质预测质量上 match or improve upon the original GigaTIME。在分布外数据上的改进尤其显著,suggesting that the foundation model backbone improves generalization to previously unseen tissue types。
 图 3:GigaTIME 和 GigaTIME-Flash 在 GigaTIME 测试集和四个分布外 Prov-TMA 队列上的平均窗口 Pearson 相关性。GigaTIME-Flash 在所有队列上 match or improve upon the original。
在不放弃基础的情况下提高效率
Flash 模型的效率提升是 substantial:
| 模型 | 类型 | 效率提升 |
|---|---|---|
| GigaPath-Flash | 全切片基础模型 | 约 50 倍更低计算,相比 GigaPath 保留 97% 的预测性能 |
| GigaTIME-Flash | 空间蛋白质组 | 约 6 倍更快,约 8 倍更低内存,相比 GigaTIME 有更好的预测性能 |
对于单个切片,这些差异减少 runtime and hardware requirements。跨数万个切片,它们可以 determine whether an experiment is practical at all。为了说明这一点,我们估计在单个 A100 GPU 上跨不同规模队列生成虚拟 mIF 的墙钟时间,假设每个切片约 10,000 个 tiles:
| 模型 | 1,000 个切片 | 100K 个切片 | 1M 个切片 |
|---|---|---|---|
| GigaTIME-Flash | ~2 GPU-hours | ~7 GPU-days | ~70 GPU-days |
| GigaTIME | ~7 GPU-hours | ~30 GPU-days | ~300 GPU-days |
估计假设每个切片约 10,000 个 tiles,批量大小 128, single NVIDIA A100 GPU。实际运行时取决于切片大小、tile 分辨率和硬件。
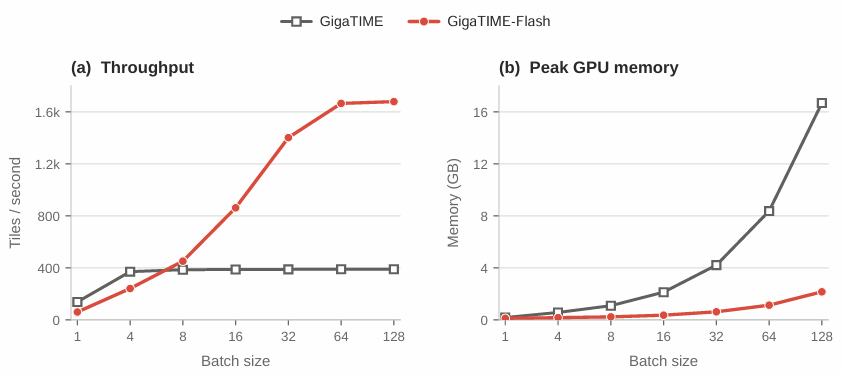 图 4:GigaTIME 效率扩展。左:吞吐量(tiles/sec)与批量大小。右:峰值 GPU 内存(GB)与批量大小。GigaTIME-Flash 扩展到超过 1,600 tiles/sec,同时使用内存的一小部分。
开放模型发布
GigaPath-Flash 和 GigaTIME-Flash 都作为开放权重模型在 Apache 2.0 许可证下发布。模型权重和代码可在 HuggingFace 上获取:
这是一个 early research release。我们当前的评估涵盖了有限的基准测试和队列集,并且在任务、扫描仪和患者群体上的更广泛验证仍是必要的。我们期望这些模型最有价值的应用将包括我们最初实验中之外的科学问题、队列和使用案例。我们欢迎社区评估,我们也同样对报告这些模型在哪里工作良好以及在哪里不足感兴趣。
下游临床应用将需要额外的多机构和前瞻性验证。
效率作为发现的推动者
GigaPath 和 GigaTIME 展示了病理基础模型可以从全切片和肿瘤组织中学习什么。GigaPath-Flash 和 GigaTIME-Flash 是使这些能力跨更大群体、更多实验和更广泛研究社区可用的 step toward。
通过使病理基础模型更高效,我们希望扩大研究人员可以提出的科学问题的规模。
致谢
GigaPath-Flash 和 GigaTIME-Flash 是 Microsoft Research、华盛顿大学和 Providence 的联合工作。技术细节见论文。
论文共同作者:Naoto Usuyama, Jeya Maria Jose Valanarasu, Sicong Yao, Hanwen Xu, Jaspreet Bagga, Guanghui Qin, Robert E. Kramer, Cliff Wong, Soohee Lee, Hao Qiu, Theodore Zhengde Zhao, Racheli Ben Shimol, Angela Crabtree, Kevin Matlock, Eduardo Alejandro Lozano Garcia, Naiteek Sangani, Alberto Santamaria-Pang, Maximilian Rokuss, Yashna Hasija, Naisargi Manishkumar Patel, Jason Entenmann, Alexandra Q. Bartlett, Bill J. Wright, Bernard A. Fox, Brian Piening, Sheng Zhang, Sheng Wang, Tristan Naumann, Carlo Bifulco, Hoifung Poon