title: "为何大多数多智能体系统即使评估通过仍会失败"
source_url: "https://towardsdatascience.com/why-most-multi-agent-systems-fail-even-when-evaluation-passes/"
author: "Towards Data Science"
excerpt: "公共早报 本文解释了为何多智能体系统即使在输出层评估通过时仍会静默失败,并提出一种中间状态评估架构,使用轻量本地看门狗模型在每次智能体间交接前对其合理性进行打分。"
如何捕捉一个看起来正确但实际不然的载荷——使用工作中的看门狗模式。 Benjamin Nweke 2026 年 9 月 7 日 10 分钟阅读
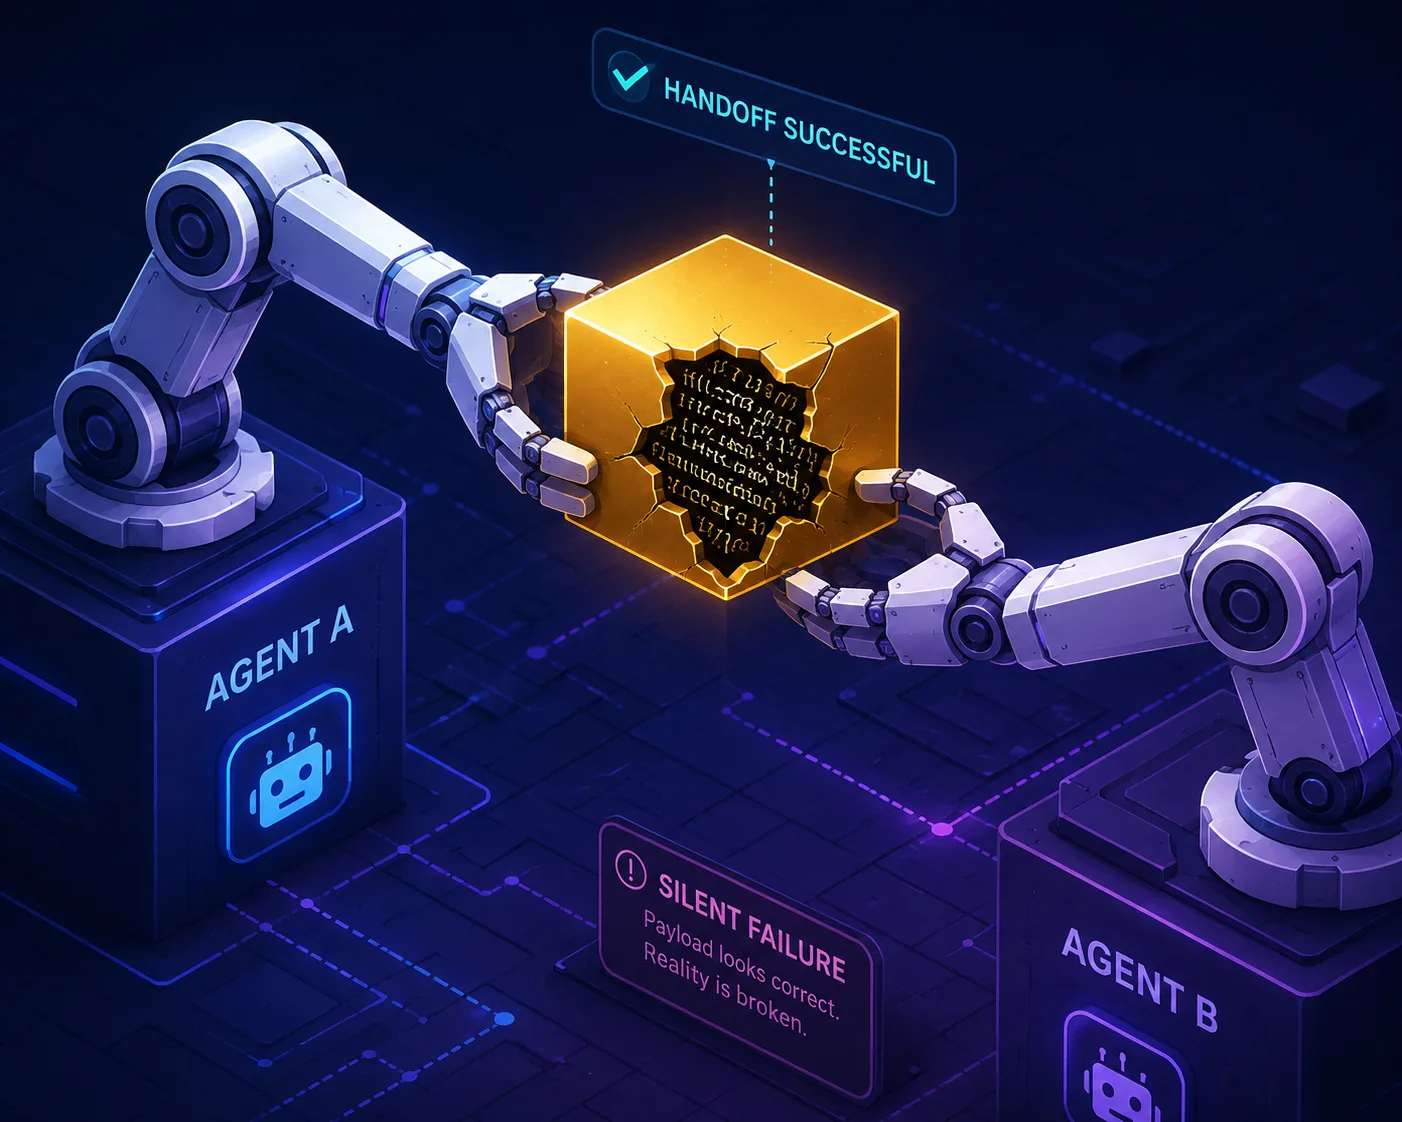 图片由作者提供(由 ChatGPT 生成)
无论在哪里把智能体串联起来,我都会遇到这个问题的某个版本。来看一个深度为三层的工单分流系统:
一个节点负责分类传入的工单,一个从内部 API 拉取客户账户历史,第三个基于两者起草解决方案或升级策略。
然后,它上线了。在演示中运行良好——说实话,以我的经验,这说明不了什么。它在生产环境的前几天也运行良好;同样,这能说明一点问题,但也还不够。
沿流程往下,收到一条投诉,是关于取消订阅退款的。账户历史节点调用了账单 API,返回了 200 状态码,并将载荷传递给下游,仿佛一切正常。
载荷是空的。没有格式错误的数据,没有超时,没有任何会在 500 报错中显示的东西。只是一个空结果集,格式与有效响应完全一致——因为账户 ID 在上两步被搞乱了,账单服务安静地为一个找不到的账户返回了空结果。
起草节点没有看到任何错误。它看到的是一个格式良好的 JSON 对象,里面没有任何记录,判断这意味着"没有账单历史",然后写了一封措辞礼貌的邮件,说明没有什么可以退还。
邮件发出去了,错误的退款决定也随之发出。但仍然没有人发现,因为整个过程没有任何地方崩溃。就系统而言,它完成了自己的工作。
我不认为需要你自己经历过这个确切场景,它才值得你花时间。
如果你在生产中的多智能体系统周围花了足够长的时间,你要么已经见过某个版本,要么迟早会遇到。
这一切都不是轶事。根据 Datadog 2026 年 AI 工程现状报告,AI 请求的生产故障率约为 5%,其中只有约 60% 来自你会通过错误代码注意到的、容量驱动的故障。
剩下的大多是上面发生的事情——一个完成了但仍然得到错误结果的请求。
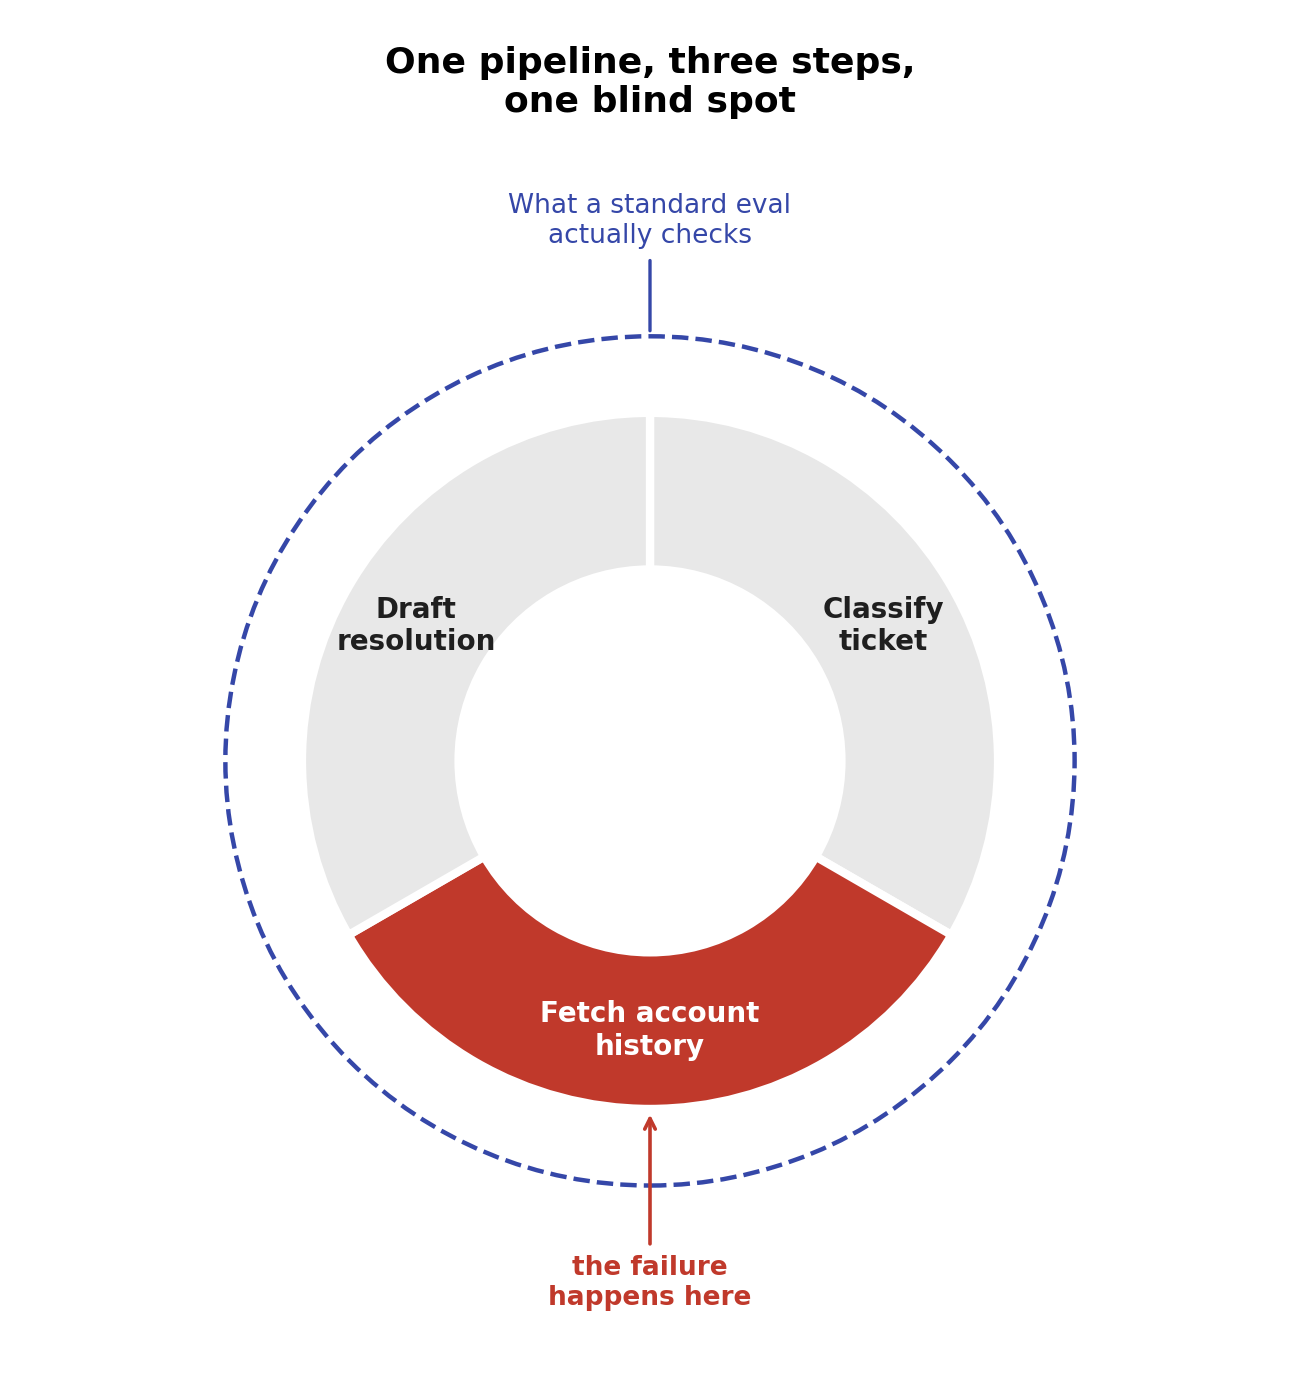
为什么没有任何检查能捕捉到它 {#why-nothing-catches-it}
用标准评估套件跑这个管线,它一路通过。最终输出读起来很好,语法正确,措辞专业。
粗略浏览的人类没有任何理由标记它,除非他们恰好去交叉核实了实际账户——这在某种程度上已经背离了自动检查的初衷。
如果用评分标准给它打分,它在解决方案质量维度上可能表现也不错。清晰、礼貌、切题。
它通过是因为所有这些检查都在看同一层:最终文本。没有一个检查询问节点二和节点三之间发生了什么。
账户历史节点没有大声失败;它是通过"成功返回了错误的东西"而失败的,而成功恰恰是输出级评估被设计来奖励的。
这是值得花比自然感觉更长的时间来思考的部分,在跳到解决方案之前。
只对编译后的输出进行评分,使你在结构上对中间状态视而不见——那些看起来正确但实际不然的状态。这不是一个在最后一个节点加一个更好提示词就能修补的缺口。它是一个盲点,源于你最初决定要观察什么的地方。
评估 UI 而不是 UI 下的应用程序 {#grading-the-ui-instead-of-the-application-underneath-it}
这里有一个我一直在回味的古老类比。没有人会发一个编译好的应用程序然后说它测试通过了,因为登录页面渲染了。
你要测试它下面的层,即支撑登录的查询、它颁发的令牌,以及沿路触发的权限检查。
UI 是 bug 最后显现的地方,而不是你首先想到要去找的地方。
目前大多数生产中的智能体评估,实质上就是在一个根本没有传统 UI 的系统上硬加上 UI 级测试。
最终文本响应是唯一被评分的对象,主要是因为它是唯一容易评分的对象。
你可以用它跑评分标准,逐行与已知正确答案比较,或者让人在喝咖啡时浏览一遍。
工具调用、节点间的 JSON 交接、传递给前方的部分推理——这些都不会被监控,除非某个东西崩溃得足够响,在某处的日志中留下痕迹。
而代价昂贵的故障模式从来不是大声的那种。500 报错,一个服务器坦白承认某处坏了,会被捕获并升级,因为系统已经预期到这种形式的失败并有相应的处理计划。
代价高的是 200——那个说一切正常的响应,附带一个结构上没问题但语义上一塌糊涂的载荷。
一种观察中间层的架构 {#an-architecture-for-watching-the-middle}
所以解决方案不是在末尾再追加一个评分标准。它是把部分评估移入管线本身,就在智能体输出变成另一个智能体输入的接缝处。
我一直称之为中间状态评估架构(Intermediate State Eval architecture)——主要是因为它需要一个名字,而这个名字恰好被记住了。核心理念是一个轻量级的评分器坐在智能体节点之间,而不是等整个链条完成后再评估。
在我们之前讨论的工单分流场景中,它位于账户历史节点和起草节点之间的一个检查点,唯一的工作是询问交接是否看起来合理:
载荷中的账户 ID 是否真的与请求的那个匹配?
这看起来像一个真实的查询结果,还是像系统在找不到目标时悄悄回退的那种默认值?
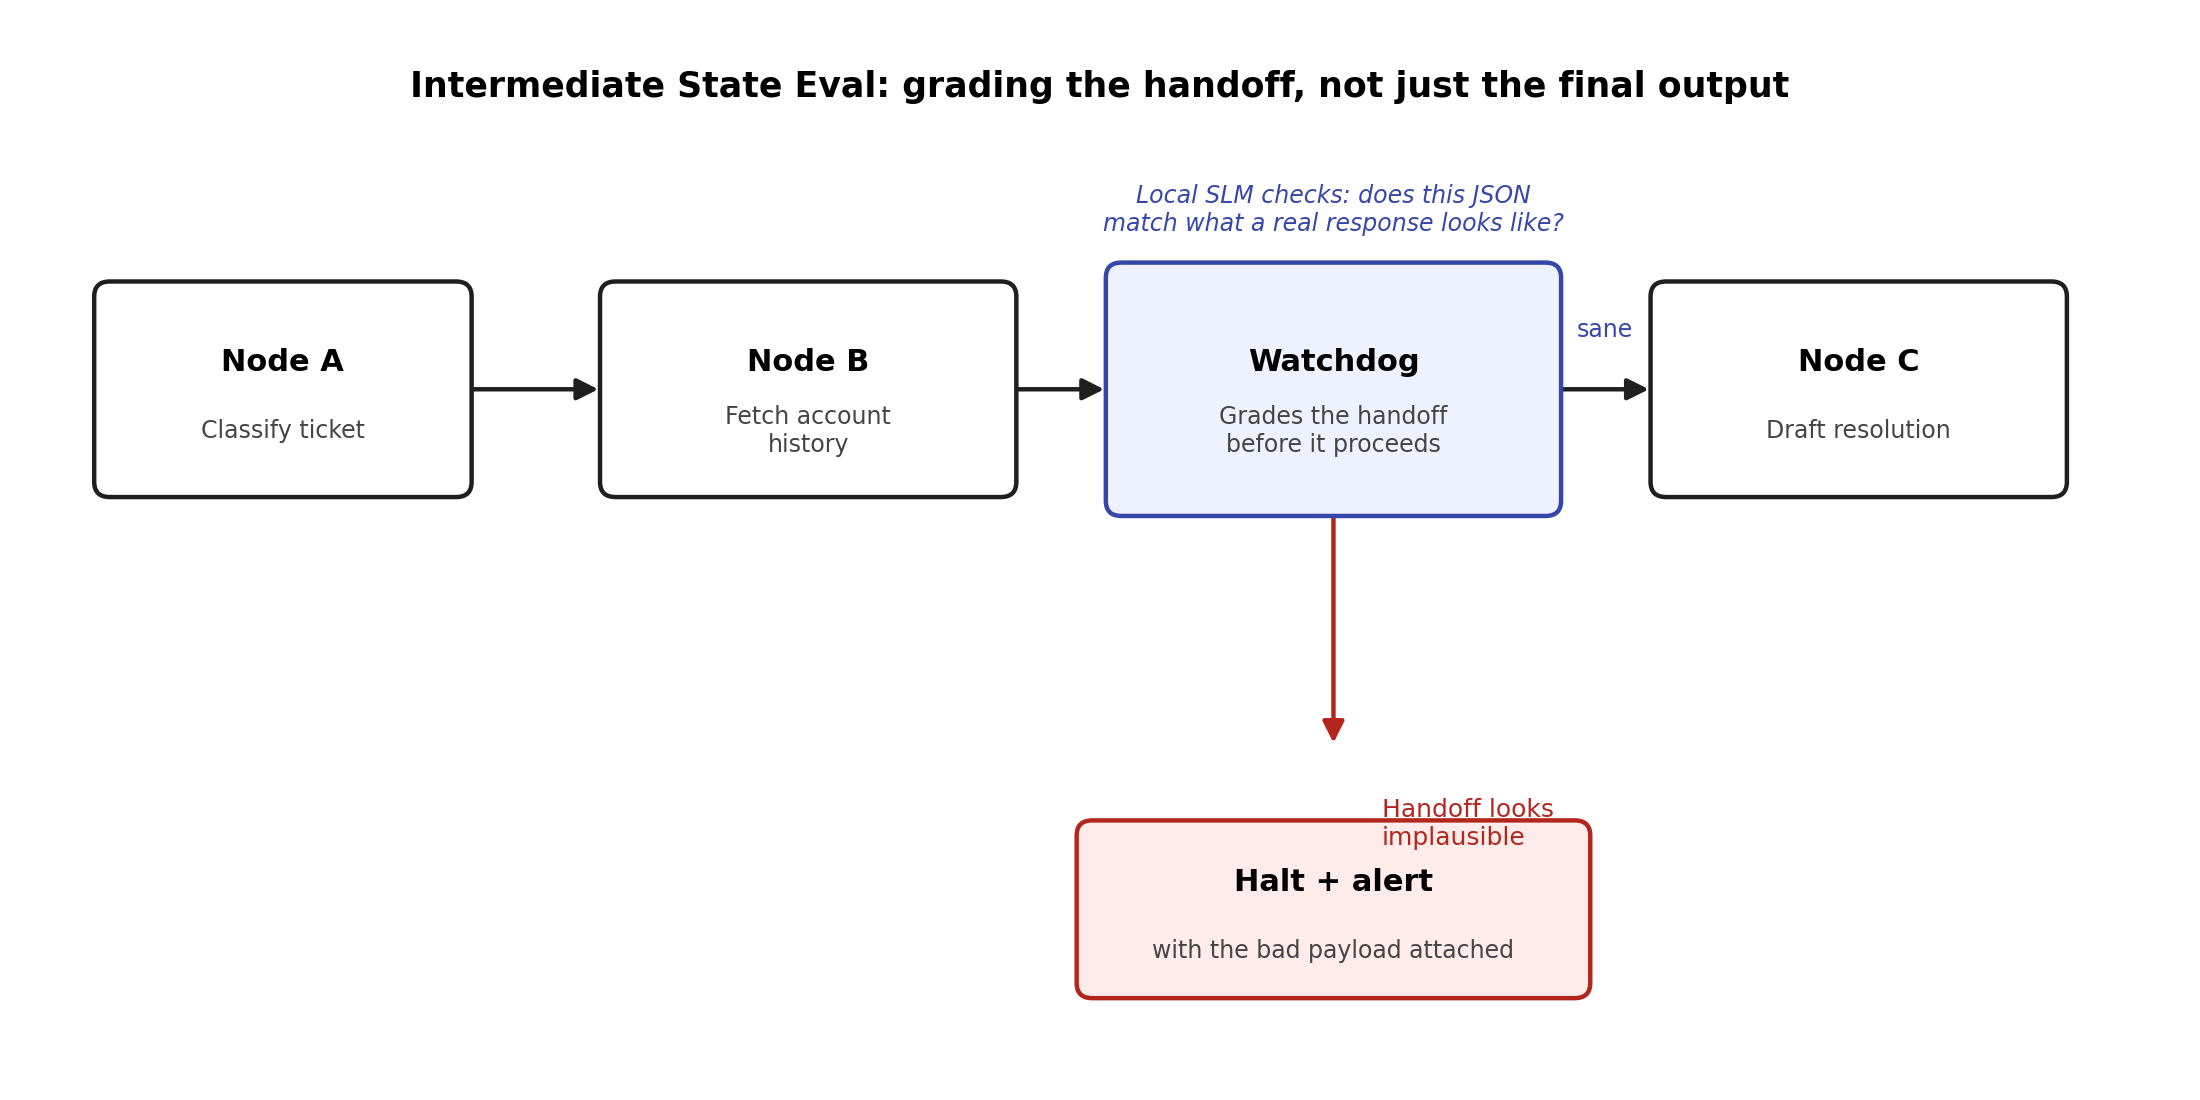
你不需要用大模型做这个判断,说实话我会建议不要这样做。
一个在节点之间充当看门狗的小型本地模型——与用模型评判另一个模型输出的基本思路相同——足以捕捉形状级别和合理性级别的问题,而保持本地运行防止了额外延迟和成本变成你正在努力解决的同一个问题的另一个版本。
它的裁决实际上不需要多聪明。它只需要快速且二元:这次交接看起来是否足够合理可以继续,还是需要在下一个节点在其上构建之前将其标记并停止?
这就是全部工作,没有更多。
以下是其实际代码。
首先定义交接本身的形状。将其定义为一个使用 Pydantic 的真实模式而不是松散的字典,是使看门狗工作成为可能的关键,因为它给了评分器一个可以具体检查的东西,而不是每次调用时临时猜测结构。
from pydantic import BaseModel, Field
import logging

logger = logging.getLogger("pipeline.handoff")

# 以下值——看门狗会将"合理"的裁决视为不合理
# 从 0.5 开始,在预发布环境被一堆低置信度但正确的交接搞崩后,
# 一直调到假暂停率不再让人烦为止
CONFIDENCE_FLOOR = 0.35

class AccountHistoryPayload(BaseModel):
    account_id: str
    subscription_status: str
    billing_records: list[dict] = Field(default_factory=list)
    lookup_source: str  # 哪个上游系统实际响应了——当这是唯一线索时,它救过我们不止一次

class HandoffVerdict(BaseModel):
    is_plausible: bool
    reason: str
    confidence: float
看门狗本身只是一个小型函数,不是你需要建立和维护的新服务。
它获取传出的载荷、产生它的请求,然后向本地模型提一个窄范围内的问题,而不是开放式问题。
保持问题窄小是全部诀窍——这就是它足够便宜、可以实际放在关键路径上而不是成为另一个瓶颈的原因。
import textwrap

# local_grader: 任何可调用对象,输入提示词返回文本
# 我们在管线同一台机器上运行一个 1B 蒸馏模型——
# 它不需要多智能,只需要快速且稳定
GRADER_PROMPT = textwrap.dedent("""\
    一个下游智能体即将收到这个账户历史载荷:
    {payload}
    它是为 account_id 请求的: {account_id}
    严格以 JSON 格式回答: {{"is_plausible": bool, "reason": str, "confidence": float}}
    在以下情况下标记为不合理:account_id 不匹配,
    对标记为 active 的订阅 billing_records 却为空,
    或载荷看起来像默认/回退值而非真实查询结果。""")

def grade_handoff(request_account_id: str, payload: AccountHistoryPayload, local_grader) -> HandoffVerdict:
    prompt = GRADER_PROMPT.format(payload=payload.model_dump_json(), account_id=request_account_id)
    raw_response = local_grader(prompt)
    try:
        verdict = HandoffVerdict.model_validate_json(raw_response)
    except ValueError:
        # 评分器本身也可能返回垃圾——如果无法解析它的裁决,
        # 不要耸耸肩就放交接过去,那就违背了初衷
        logger.error("评分器返回无法解析的输出,阻止交接: %r", raw_response[:200])
        return HandoffVerdict(is_plausible=False, reason="grader output unparseable", confidence=0.0)

    if not verdict.is_plausible or verdict.confidence < CONFIDENCE_FLOOR:
        logger.warning(
            "交接被拒绝 account_id=%s: %s (confidence=%.2f)\npayload=%s",
            request_account_id, verdict.reason, verdict.confidence, payload.model_dump_json(),
        )
    return verdict
而编排的连接代码实际上和它听起来一样朴素——这是故意的。在你的管线某处,已经有函数在处理分类和起草最终解决方案。
这里唯一的新部件是坐在它们之间的门,用评分交接并抛出异常,而不是像以前那样悄悄让坏载荷流到写客户面向响应的那个环节。
class HandoffRejectedError(Exception):
    pass

def run_pipeline(account_id: str, account_data: dict, local_grader) -> AccountHistoryPayload:
    payload = AccountHistoryPayload(**account_data)
    verdict = grade_handoff(account_id, payload, local_grader)
    if not verdict.is_plausible:
        # 这里替换了以前悄悄发出错误邮件的做法——
        # 在这里抛异常固然烦人,但比发出一笔不该存在的退款要好得多
        raise HandoffRejectedError(f"account_id={account_id}: {verdict.reason}")
    return payload  # 安全地交接给起草解决方案的后续环节
这一切都不花哨,如果有人把它包装得听起来像是什么了不起的东西,我会略持怀疑态度。
它就是一个模式定义、一个窄范围的评分调用,以及一个以前是悄悄通过现在改为抛出异常的地方。
价值从来不在任何一个部件的复杂性上。它完全在于你决定把检查放在哪里。
实际的好处是失败不再静默发生。不再是错误邮件在真实问题发生三步之后才发出,管线在腐败发生的那个点就停住,真实的坏交接附加在触发警报的信息上。
这把一笔损害信任的支持升级工单,变成了一次耗时几分钟的调试会话。
它带来的成本 {#what-this-costs-you}
这一切都不是免费的,我宁愿提前说明白,也不要卖给你一个没有缺点的严格改进——因为根本没有,但有三个方面需要考虑:
- 延迟: 简单直接。对于三节点管线,有两个额外的推理调用正好在关键路径上,如果你在构建对响应时间真正有要求的系统,成本会快速累积。
- 新的故障面: 一个校准不当的看门狗开始拒绝完全良好的交接,用无声损坏换成了另一种烦恼——假暂停,现在需要人工分类。阈值调优正确需要真正的迭代,不是一个设完就不再动的数字。
- 判断力: 决定某次交接是否真的值得评分,而不是为自身添加开销,完全取决于在那个特定节点出错代价有多高。
不是每个节点都需要一个看门狗坐在上面。位于外部面向操作之前的节点——邮件即将发出、退款即将实际执行——才是在那个边界捕捉坏交接的收益明确大于额外跳转成本的节点。
其他所有地方,你可能只是在为了显得全面而添加延迟。
···
思考 {#final-thoughts}
如果你今天已经在运行一个多智能体管线,想试试这个而无需拆掉整个系统,不要从链条开头开始。
相信我。
从最后一次内部交接开始——就在外部实际发生之前,邮件即将发送、记录即将写入、决策即将被执行之前。那是你首先值得 instrument 的边界。
给它一两周时间,看看看门狗实际捕捉到了什么,让这些发现告诉你是否值得进一步向管线深处推进。
你不需要在第一天就拥有完整架构才能从中获益。
下次你拥有的管线出了故障,问问自己:在输出本身看起来错误之前,你的评估能捕捉到它吗?
大多数时候,诚实地说,答案是不能。那个缺口正是你系统中最危险的交接一直在等待被发现的地方——等待着有人去看。
你的最终输出可能欺骗你。轨迹不会。
···
在你离开之前! {#before-you-go}
我写的是决定 AI 系统在生产环境中能否扛住的工程决策。如果你想看到更多这类内容,可以 订阅我的通讯。
与我联系
作者:Benjamin Nweke AI Agents · Artificial Intelligence · LLM · Machine Learning · Python