 林渡
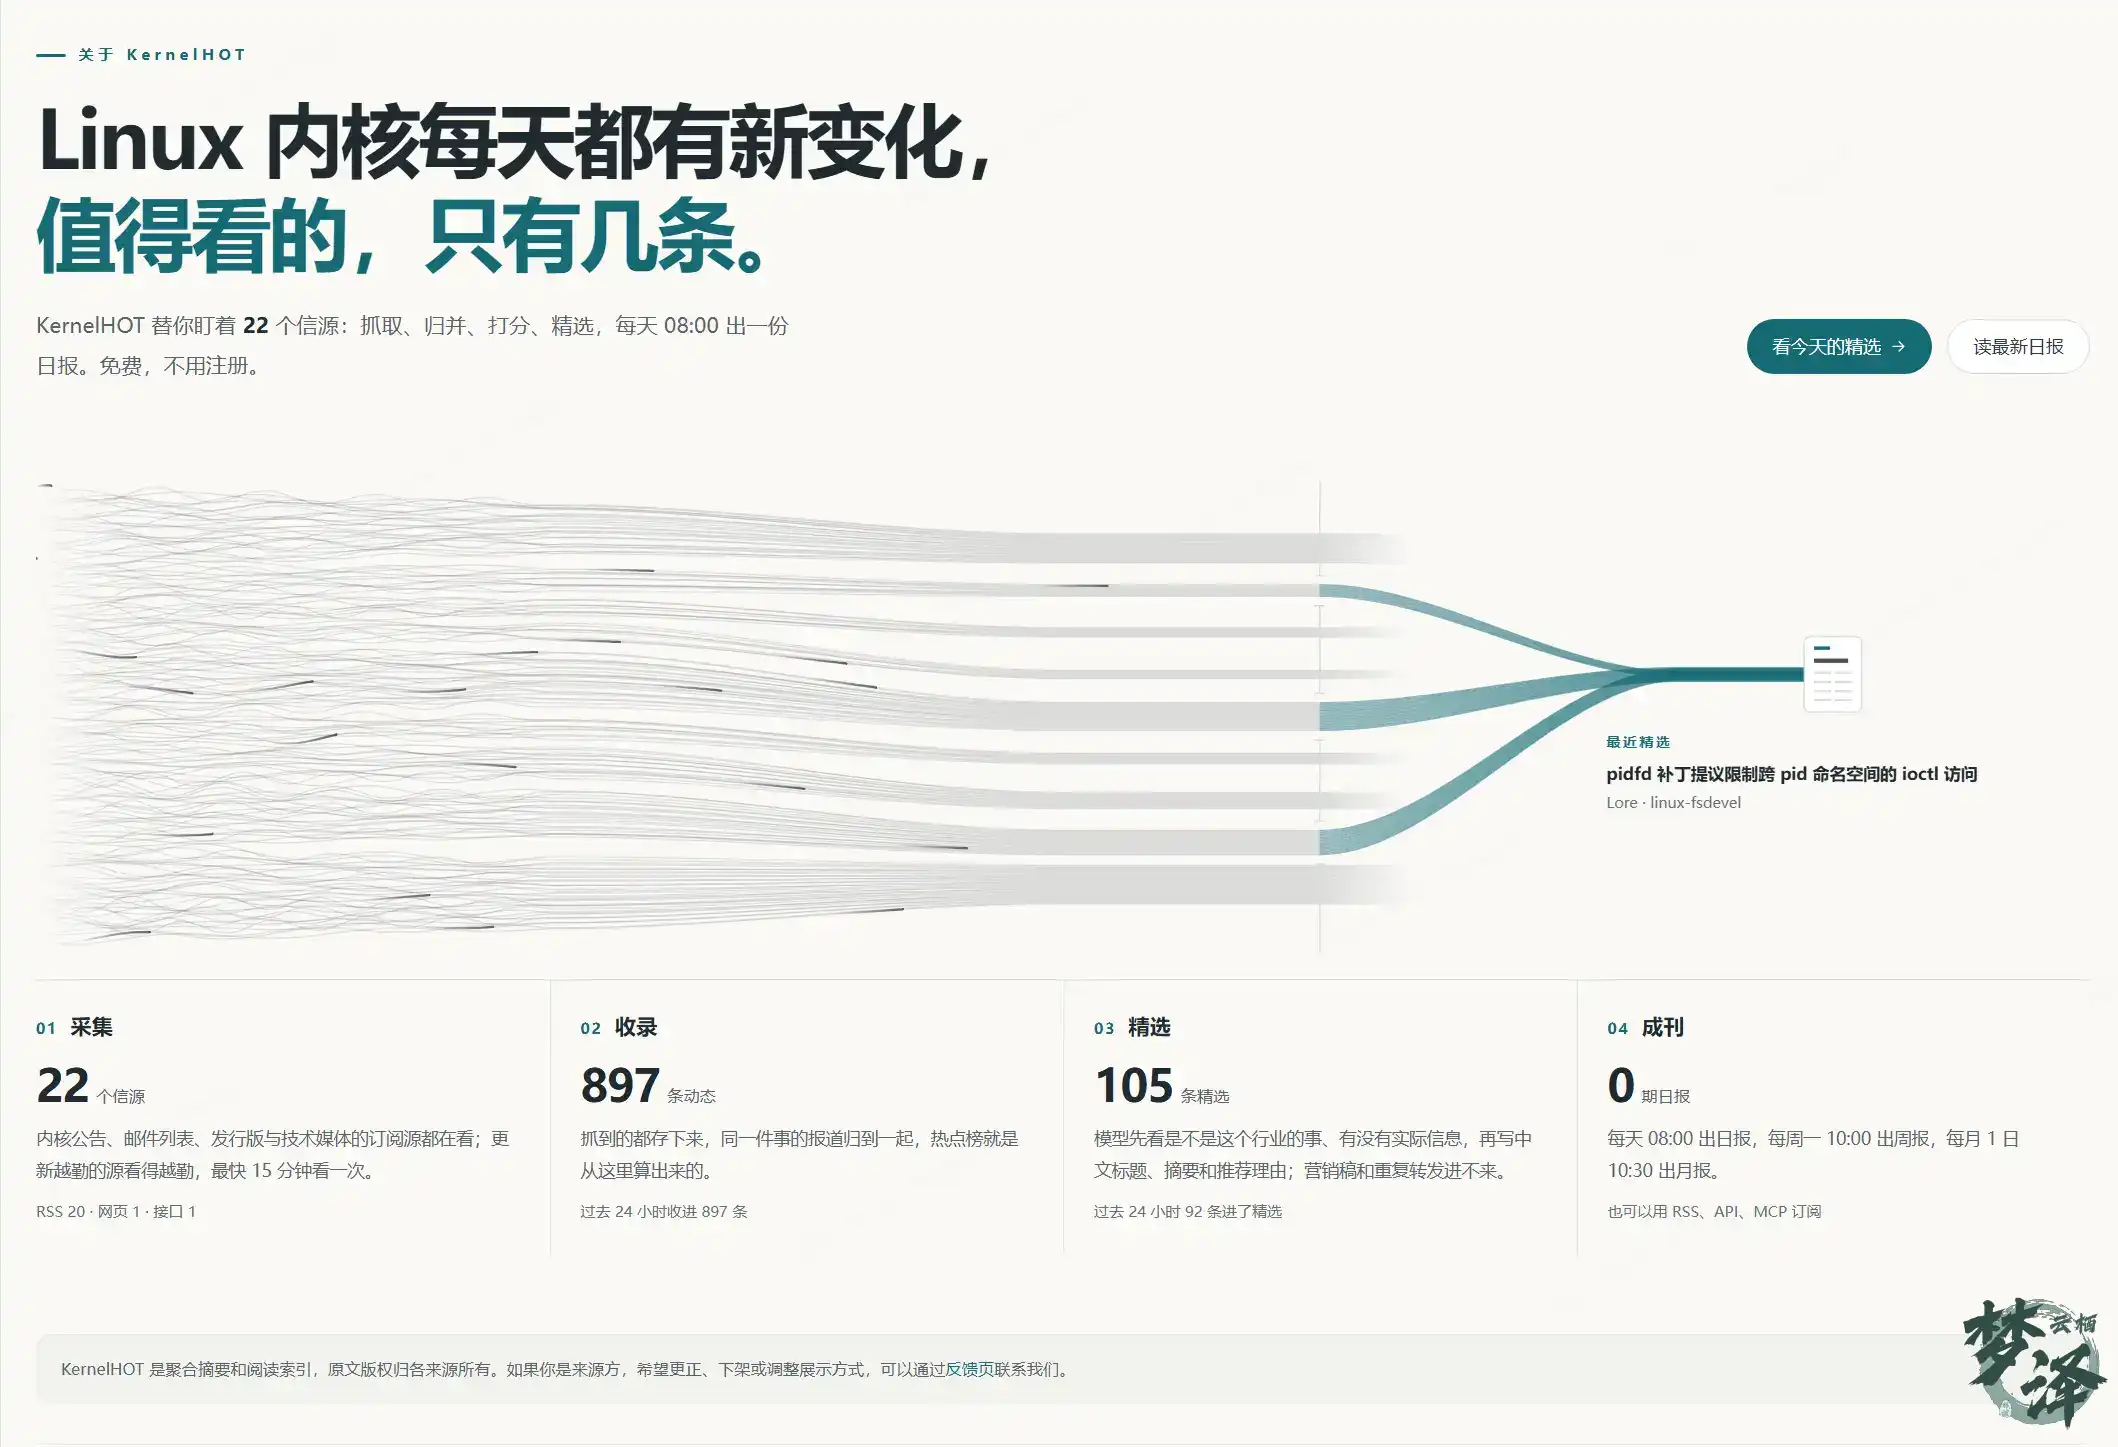
KernelHOT 是一个基于 AIHOT 框架改造的 Linux 内核领域 热点自动聚合站。本文记录改造思路、框架工作原理,以及为什么任何一个行业都能用它搭出自己的热点站。
📦 开源地址:github.com/lindoo67/KERNELHOT
🌐 在线站点:KERNELHOT
前言
在开源和开发者社区里,我们经常遇到一个共同的痛点:信息源太分散。邮件列表、博客、RSS、论坛、安全公告、发布页面……每天要刷十几个地方才能跟上最新动态。
对于 AI 行业来说,AIHOT 出现之前,我也经历过同样的焦虑——碎片化的信息、重复的转载、淹没在噪音中的重要信号。但 AIHOT 解决了我的问题,之后我就在想:有没有一个东西,能让其他技术社区也受益?
最近,原作者将 AIHOT 的核心框架完整开源了。基于这个框架,我把它改造成了一个专门关注 Linux 内核 领域的热点站——KernelHOT。这篇文章想记录一下我的改造思路、这个框架的工作原理,以及它为什么值得被任何一个技术领域采用。
AIHOT 是什么?
AIHOT 是原作者(网名「数字生命卡兹克」)开发的一个行业热点自动聚合站。它的核心思路简单却锋利:
把信源换成你的,把精选标准换成你的 KnowHow,它就是你的行业热点站。
具体来说,它每天从一批信源中自动采集资料,用大语言模型进行筛选、评分、写作,把不同来源报道的同一件事聚合成一个事件,按"有多少人在说"排出热点排行,每天早上自动出一份日报。
整个流程全自动运行。更重要的是:读者打开页面不会触发任何模型调用。模型只在后台 worker 任务里运行,前端只读数据库里已有的结果。这意味着你的用户数量再翻十倍,也不会多花一分模型费用。
这个仓库之所以开源,是因为原作者发现很多做法律、做 HR、做金融的朋友也想有个类似的站点,但他一个人做不过来。他在 README 里写:
我不懂你们的行业,不知道哪些信源有用,也不知道什么样的消息对你们来说才叫热点。但你们懂。 既然没办法满足所有人,就把火种交到大家自己手上。
它是怎么工作的
整个系统的工作流有六个步骤。理解了这个流程,你就理解了它为什么能在低运营成本下维持高质量输出。
Step 1:采集
框架原生支持 6 种信源:RSS、网页列表、JSON 接口、X(Twitter)账号、微信公众号,以及外部脚本推送的内容。信源分三个等级——官方一手、官方账号与准官方、媒体与个人,不同等级有不同入选门槛,抓取频率也会按产出自动调整。
在 KernelHOT 中,我配置的首批信源覆盖了 Linux 内核开发的整个信息生态:
T1 信源的入选门槛更高,意味着只有真正重要的消息才会被保留。
Step 2:预筛 + 双评分
一条资料进来后,系统先做判重(同样的内容不会进来两遍),再做预筛——判断这条资料是否值得进一步处理。
通过了预筛的内容会独立打两次分。两次评分互不参考,最后取平均。这是一个简单但非常重要的设计:它有效对冲了大模型输出的不确定性,避免一次发挥失常或偶然偏颇就决定了内容的去留。
Step 3:写作
评分过关后,模型会产出:
中文标题(外文明文自动翻译)
答案先行的摘要——第一段就告诉你"这件事是什么"
推荐理由——为什么值得关注
分类和标签抽取——方便后续归类和搜索
这里有一个细节我特别欣赏:防止模型把原文没提到的公司写进标题。幻觉控制在内容型产品里是个老大难问题,原作者在这里做了专门的约束,确保标题忠实于原文。
Step 4:归组聚簇
这是整个系统最见功力的部分。
同一件事,内核邮件列表发一篇、LWN 转一篇、Phoronix 分析一篇、X 上吵一天——如果读者看到四条新闻,信息密度就稀释了四倍。
系统的做法是:先用向量搜索(没配向量服务时则退化为文字重合度匹配)在最近两周里找候选,再让模型判断这是同一件事、后续进展,还是两件不同的事。拿不准的时候选择合并,宁多勿少。写入数据库之前,还会让模型再做一次复核。
更关键的是:人工修改过的归属不会被覆盖。管理员可以手动调整归组结果,系统会尊重人工判断。
Step 5:热点计算
热度按事件算,不按文章算。这个区别很重要。
具体规则:48 小时窗口内,每个独立来源只算一次热度权重。一家媒体一天发十篇同一件事,也只算一次。所以排在前面的,是真正"有很多独立来源都在报道"的事。
此外,和 6 小时前比涨得快的标 "↑ 上升",新出现的事件标 "🆕 新",让你一眼看到趋势。
Step 6:成刊(日报/周报/月报)
日报默认每天 08:00 出刊,从当天精选中按规则自动编排:
一件事一条,不重复
报过的事只在有新进展时才跟进
日报不调用模型,纯规则汇编——零模型成本
每周一下午出周报,每月 1 日出月报。这两个周期里模型只负责写总述和栏目导读,大部分内容直接从日报里汇编。
几点出刊、一天出几次刊,改 site/site.ts 里的 EDITION_TIMES 就行,不需要动代码逻辑。
KernelHOT 的改造实录
这个框架的设计精髓在于:大部分定制不需要改代码。
没有动的部分
apps/(前端、后端 API、worker)和 packages/(后端业务逻辑、公共类型)基本原封不动:
React Router SSR 前端 + Fastify API 架构
采集调度、模型调用、回执与预算熔断机制
聚簇算法、热度计算、日报周报月报编排
数据库迁移体系、测试体系
六大公开出口(网页、RSS、API v1、MCP、llms.txt、站点地图)
安全阀设计(采集、模型调用、推送都是默认关闭的开关)
这些是框架的通用能力,和具体行业无关。
改造的部分
site/ —— 站点身份
这个文件夹管理"这个站叫什么、叫什么行业、页面长什么样":
industry/ —— 行业包(核心改造区)
这是整个改造中最关键的部分,决定了"什么算热点":
prompts/ 里有十几份提示词文件,覆盖预筛、评分、摘要、写作、归组、日报等每一个环节。你的行业 KnowHow 就是写在这里。改标准就是改 Markdown 文件,不需要部署、不需要编译。
六大公开出口:给读者看的内容,也要给 Agent 用
框架的设计哲学很超前:给读者看的内容,也要给 Agent 用。同一个数据源,向外提供六种读取方式:
这意味着 KernelHOT 不仅是一个给人看的网站,也是一个结构化的数据源——你可以让 Claude 直接用它提供的 MCP 工具查 Linux 内核的热点事件。
后台管理
除了面向读者的界面,框架还自带完整的后台管理系统(/admin):
信源管理:添加新信源、试抓预览
内容诊断:查看每条内容的评分和归组结果,手动修正
模型配置:流程中的每一步单独换模型(比如评分用 A,写作用 B)
预算熔断:设置每个付费服务的每分钟/每小时/每天上限,超了就暂停
运行记录:告警日志、任务队列状态、清理记录
为什么这个框架有价值
1. KnowHow 不需要写代码
一个行业的人最宝贵的东西是"什么重要、什么不是噪音"的判断力。这个框架把这种判断力存成提示词和门槛配置,而不是写死在代码里。
换行业不是写代码,是写 Markdown。
2. 提示词和门槛完全公开
不像很多 AI 产品把核心逻辑藏在黑盒里,AIHOT 的每一步提示词都在 industry/prompts/ 里,一目了然。你可以看到模型被要求判断什么、怎么打分、写出什么样的摘要。
透明是可审计的前提。
3. 双评分:用朴素的方法对冲不确定性
独立打两次分再取平均,不需要额外的工程投入,效果却比单次评分稳定得多。这是"简单但有效"的典范。
4. 聚簇让信息密度真正翻倍
同样是关注 Linux 内核的人,如果你知道一个 patch 被 12 个独立来源报道过,和只看到 LWN 一篇文章,感知的权重是完全不同的。聚合本身就是信号。
5. 用户再多也不花模型费
读者打开页面不调用模型,模型只在后台定时任务里运行。十万用户和一千用户,模型费用一样。
6. 性能不拉胯
线上实测:页面中位数 10ms,95% 在 50ms 内;接口中位数 6ms,95% 在 12ms 内。对于每天更新一次的站点来说,这个性能绰绰有余。
想试试?从这里开始
如果你想为自家技术社区也搭一个类似的站点,最简单的路径:
Fork 或克隆 AIHOT 仓库
读
AGENTS.md和docs/customize.md把仓库交给 AI 编码助手(Claude Code、Codex 都行),然后说:
请读 AGENTS.md 和 docs/customize.md,把这个站改成「XX 行业」的热点站。 我关心的是:……(写你想盯的信源、你觉得什么消息重要、什么不重要,越具体越好)。 改完帮我跑测试,告诉我还需要我自己决定哪些事。
最值得花时间的是评分标准——拿一两百条你自己标注过的资料,跑评测脚本,看它选得准不准,再回去改提示词
要改的东西几乎都在 site/ 和 industry/ 这两个文件夹里。代码层面,框架本身就是一份现成的、可跑的通全量测试的 TypeScript 项目,直接拿来用。
KernelHOT 的开源地址
这是我改造的 KernelHOT 项目,完整开源:
📦 仓库:github.com/lindoo67/KERNELHOT
基于 AIHOT (MIT License) 构建。
如果你也在关注 Linux 内核领域,欢迎 star、提 issue,或者 fork 出去改成你自己的项目。
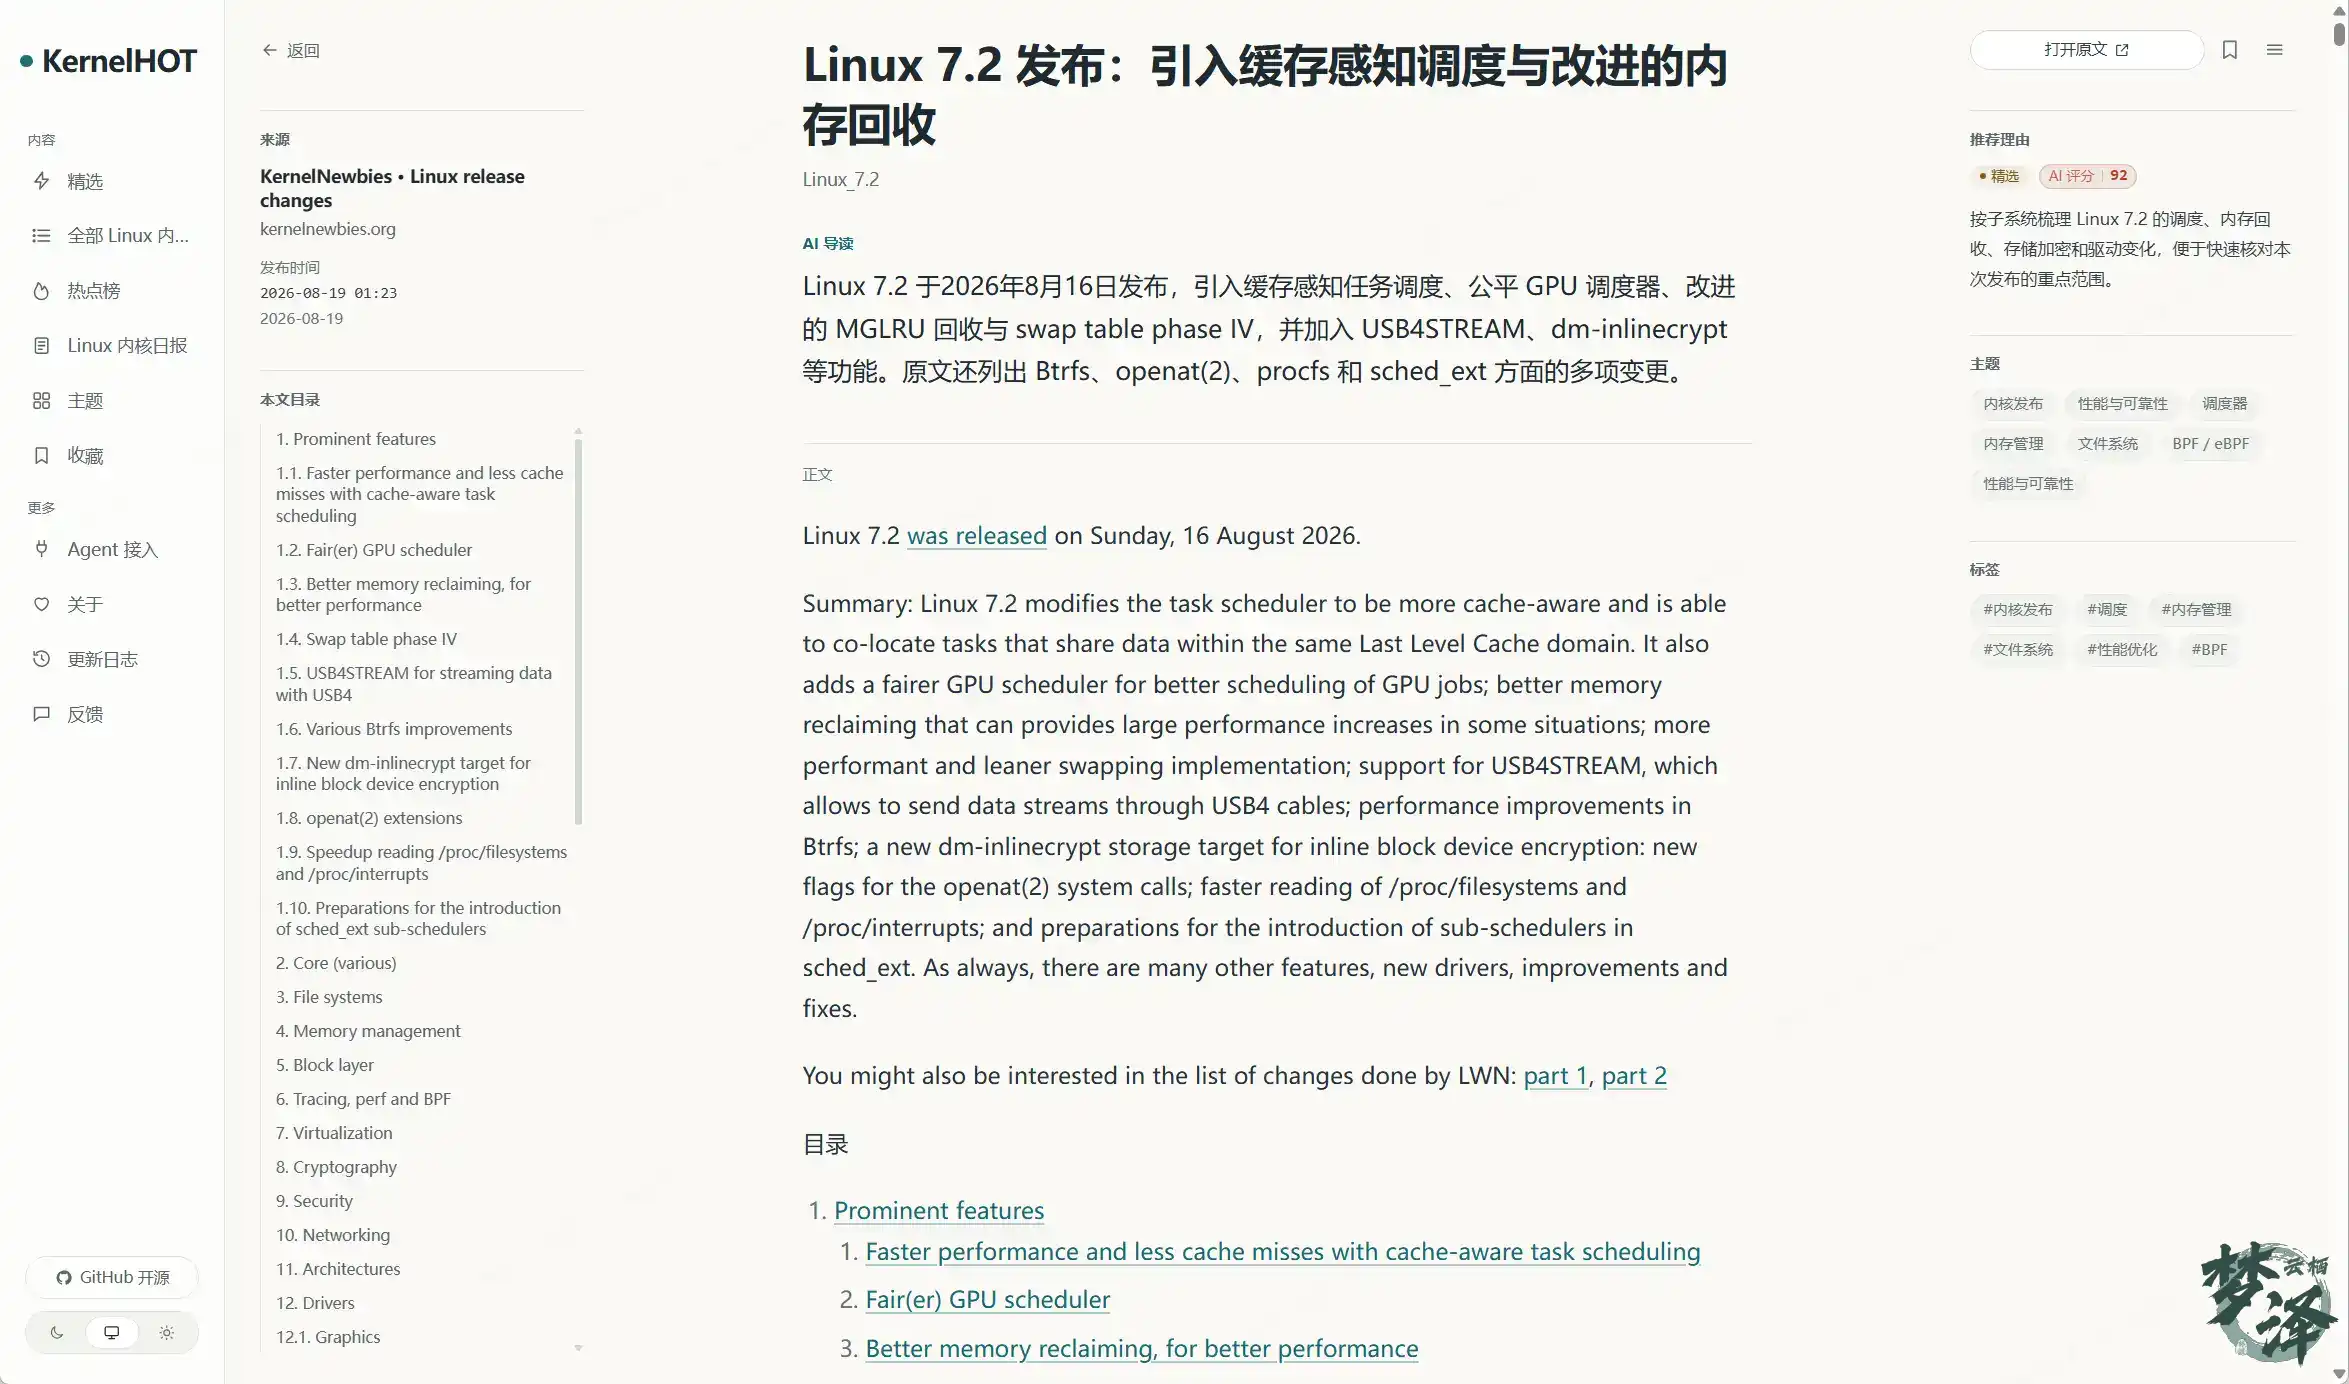
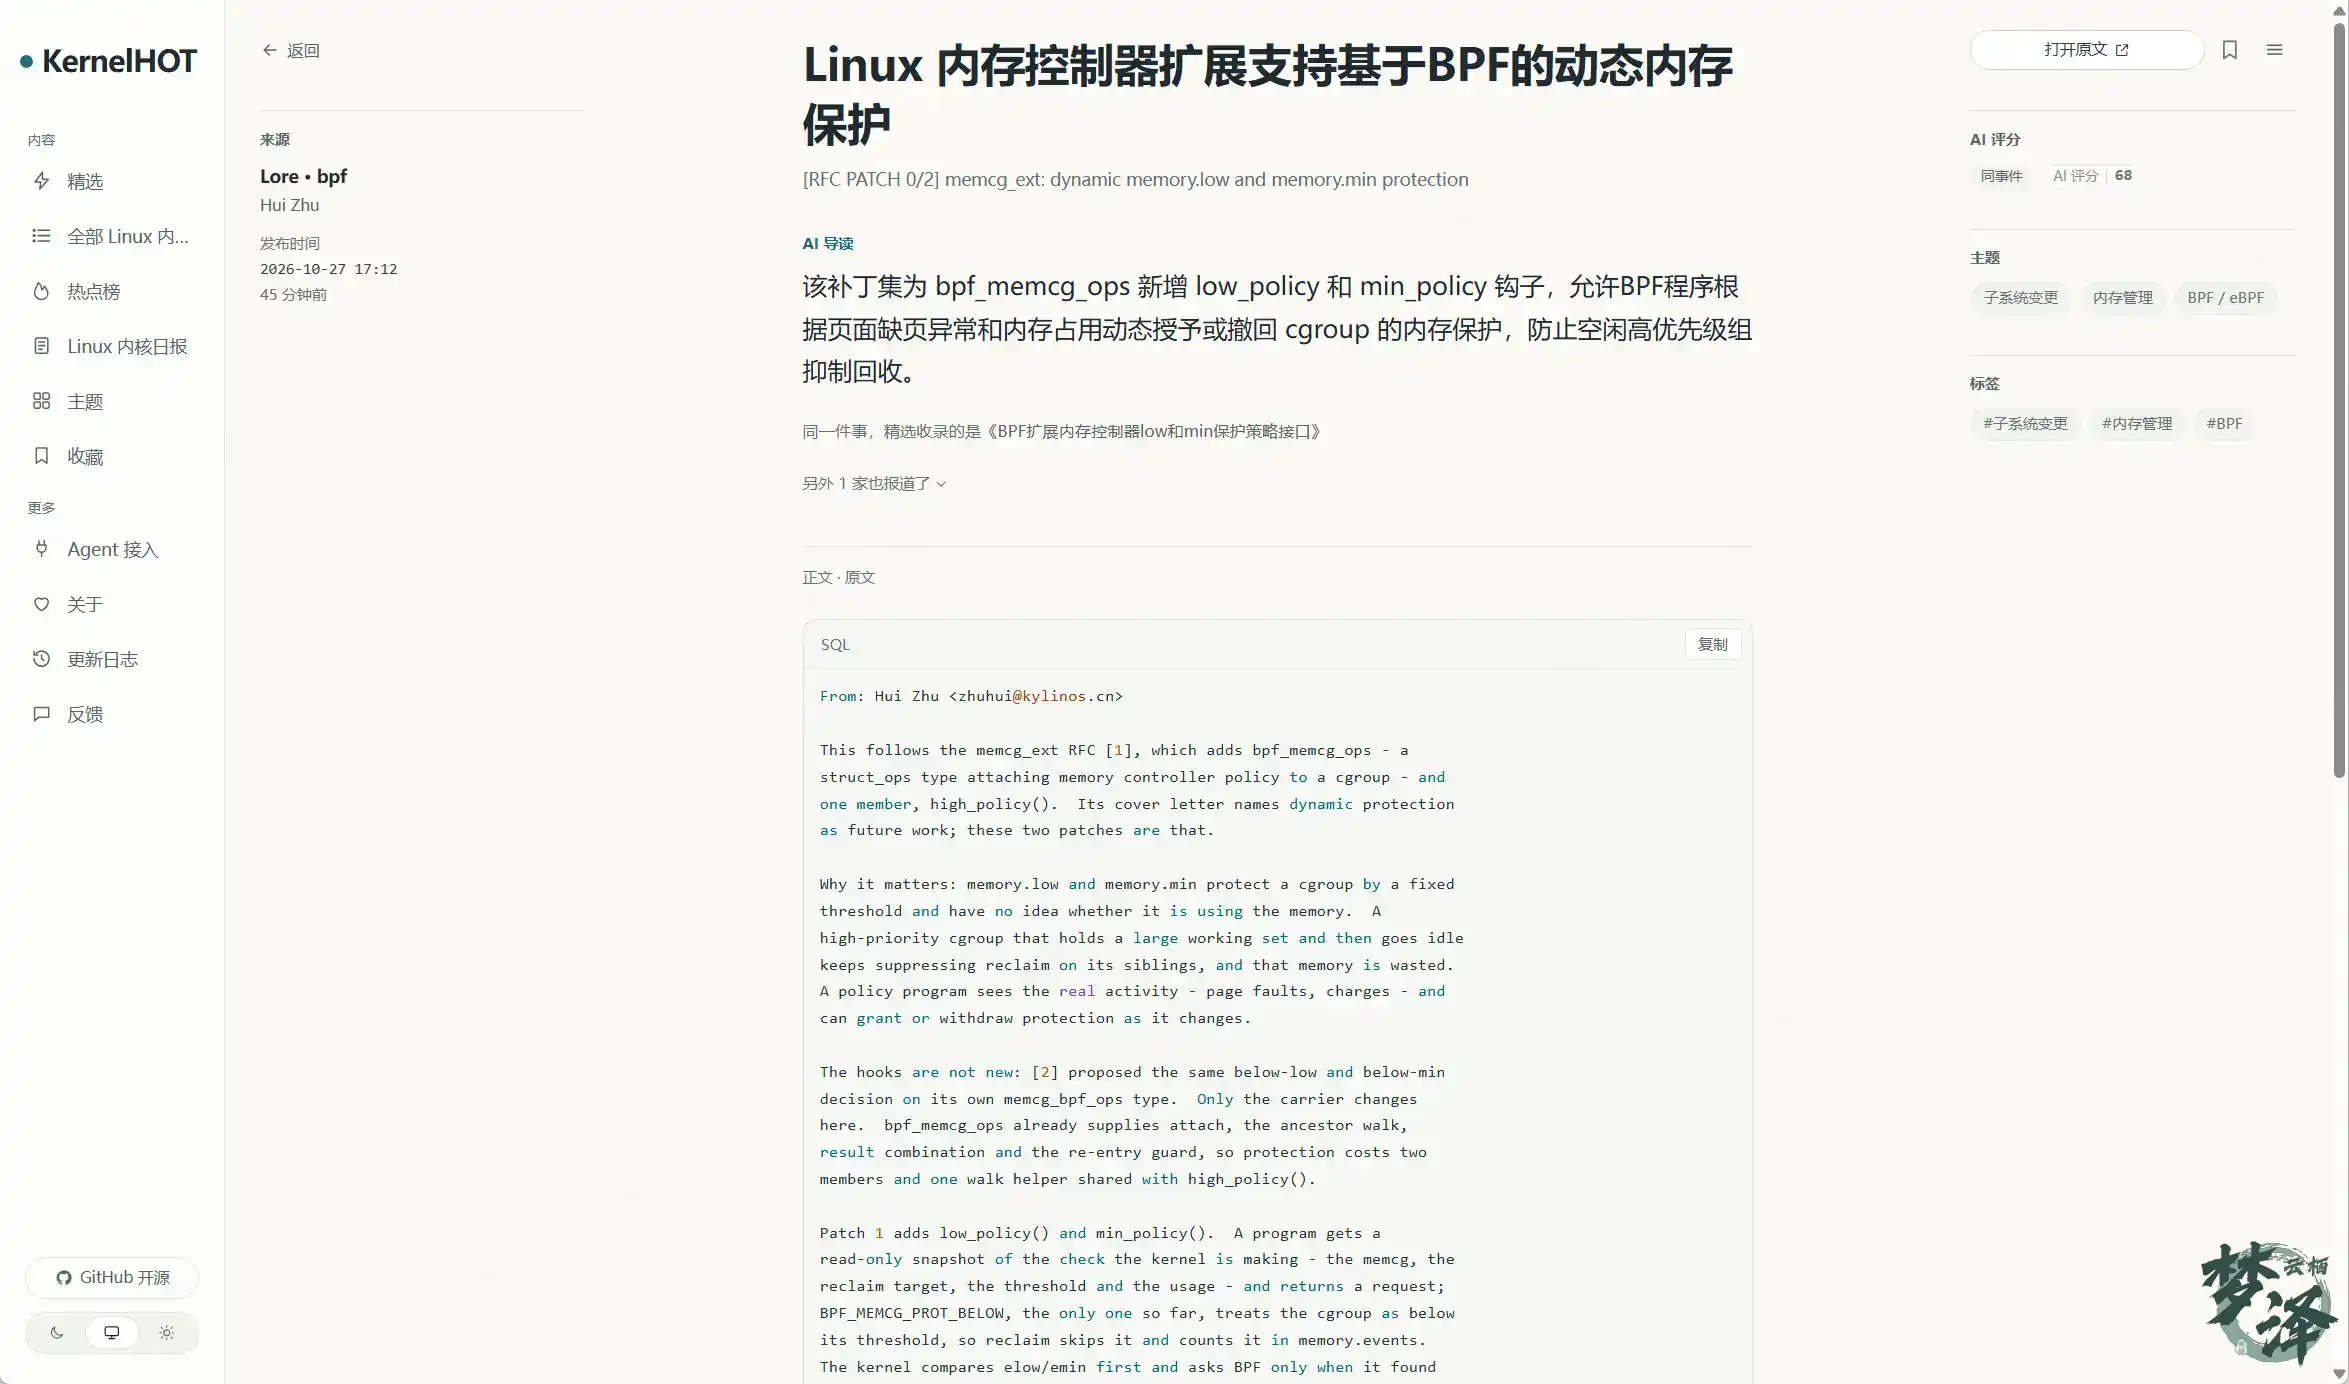
KernelHOT图赏
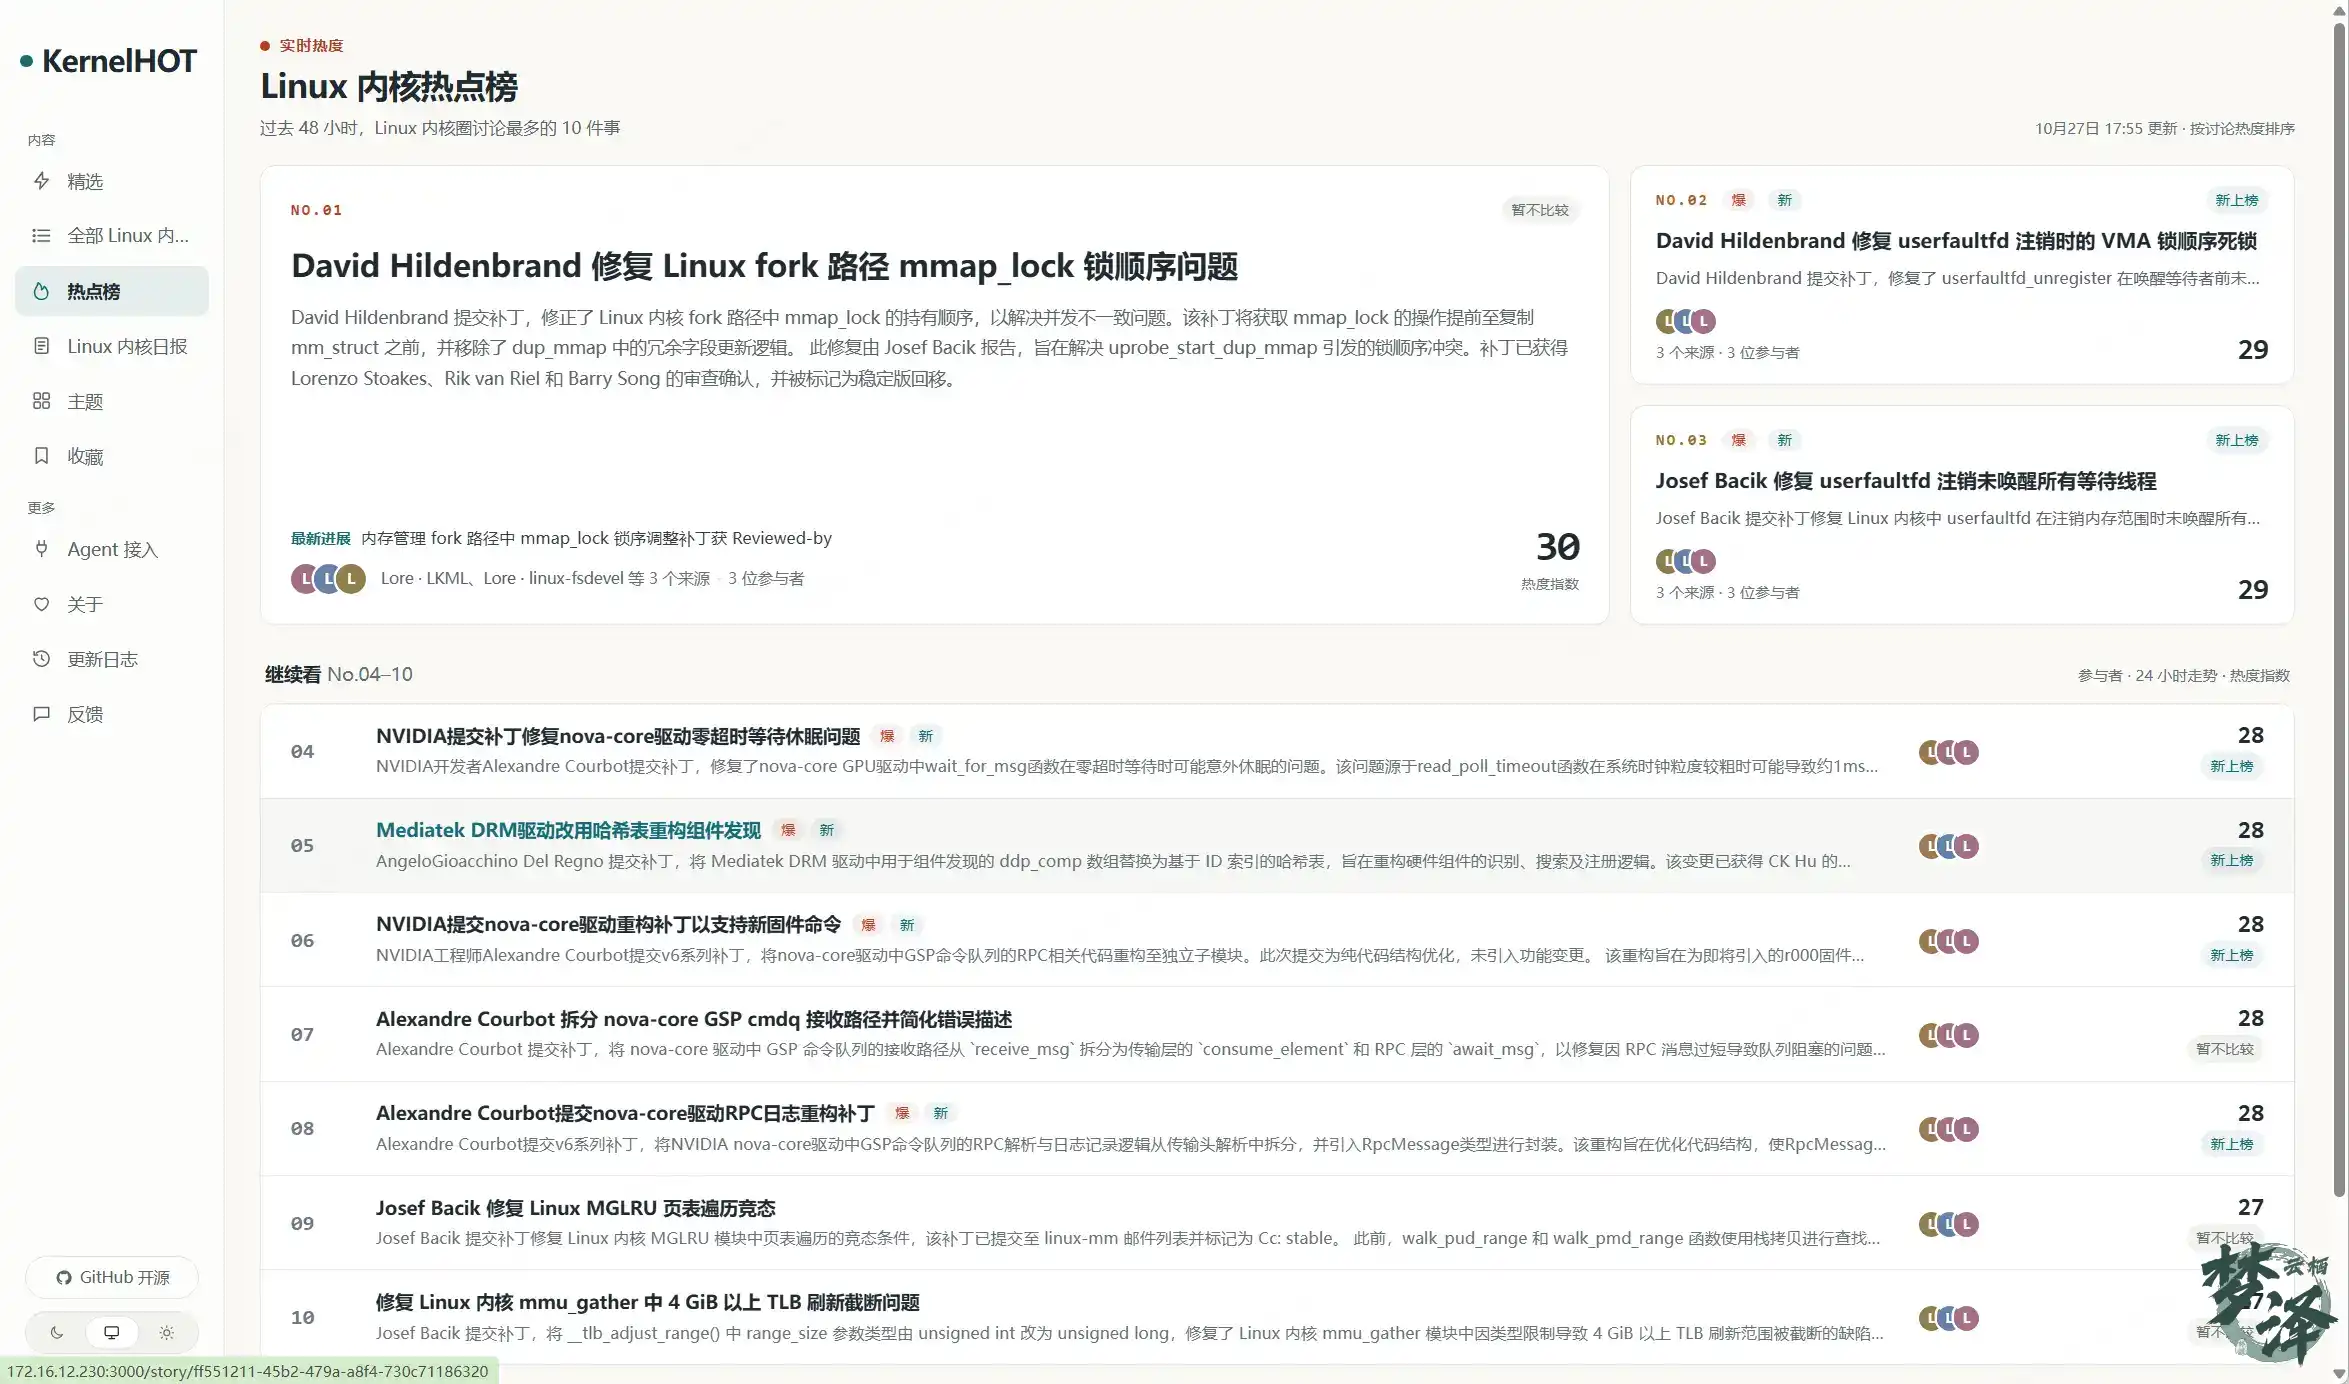
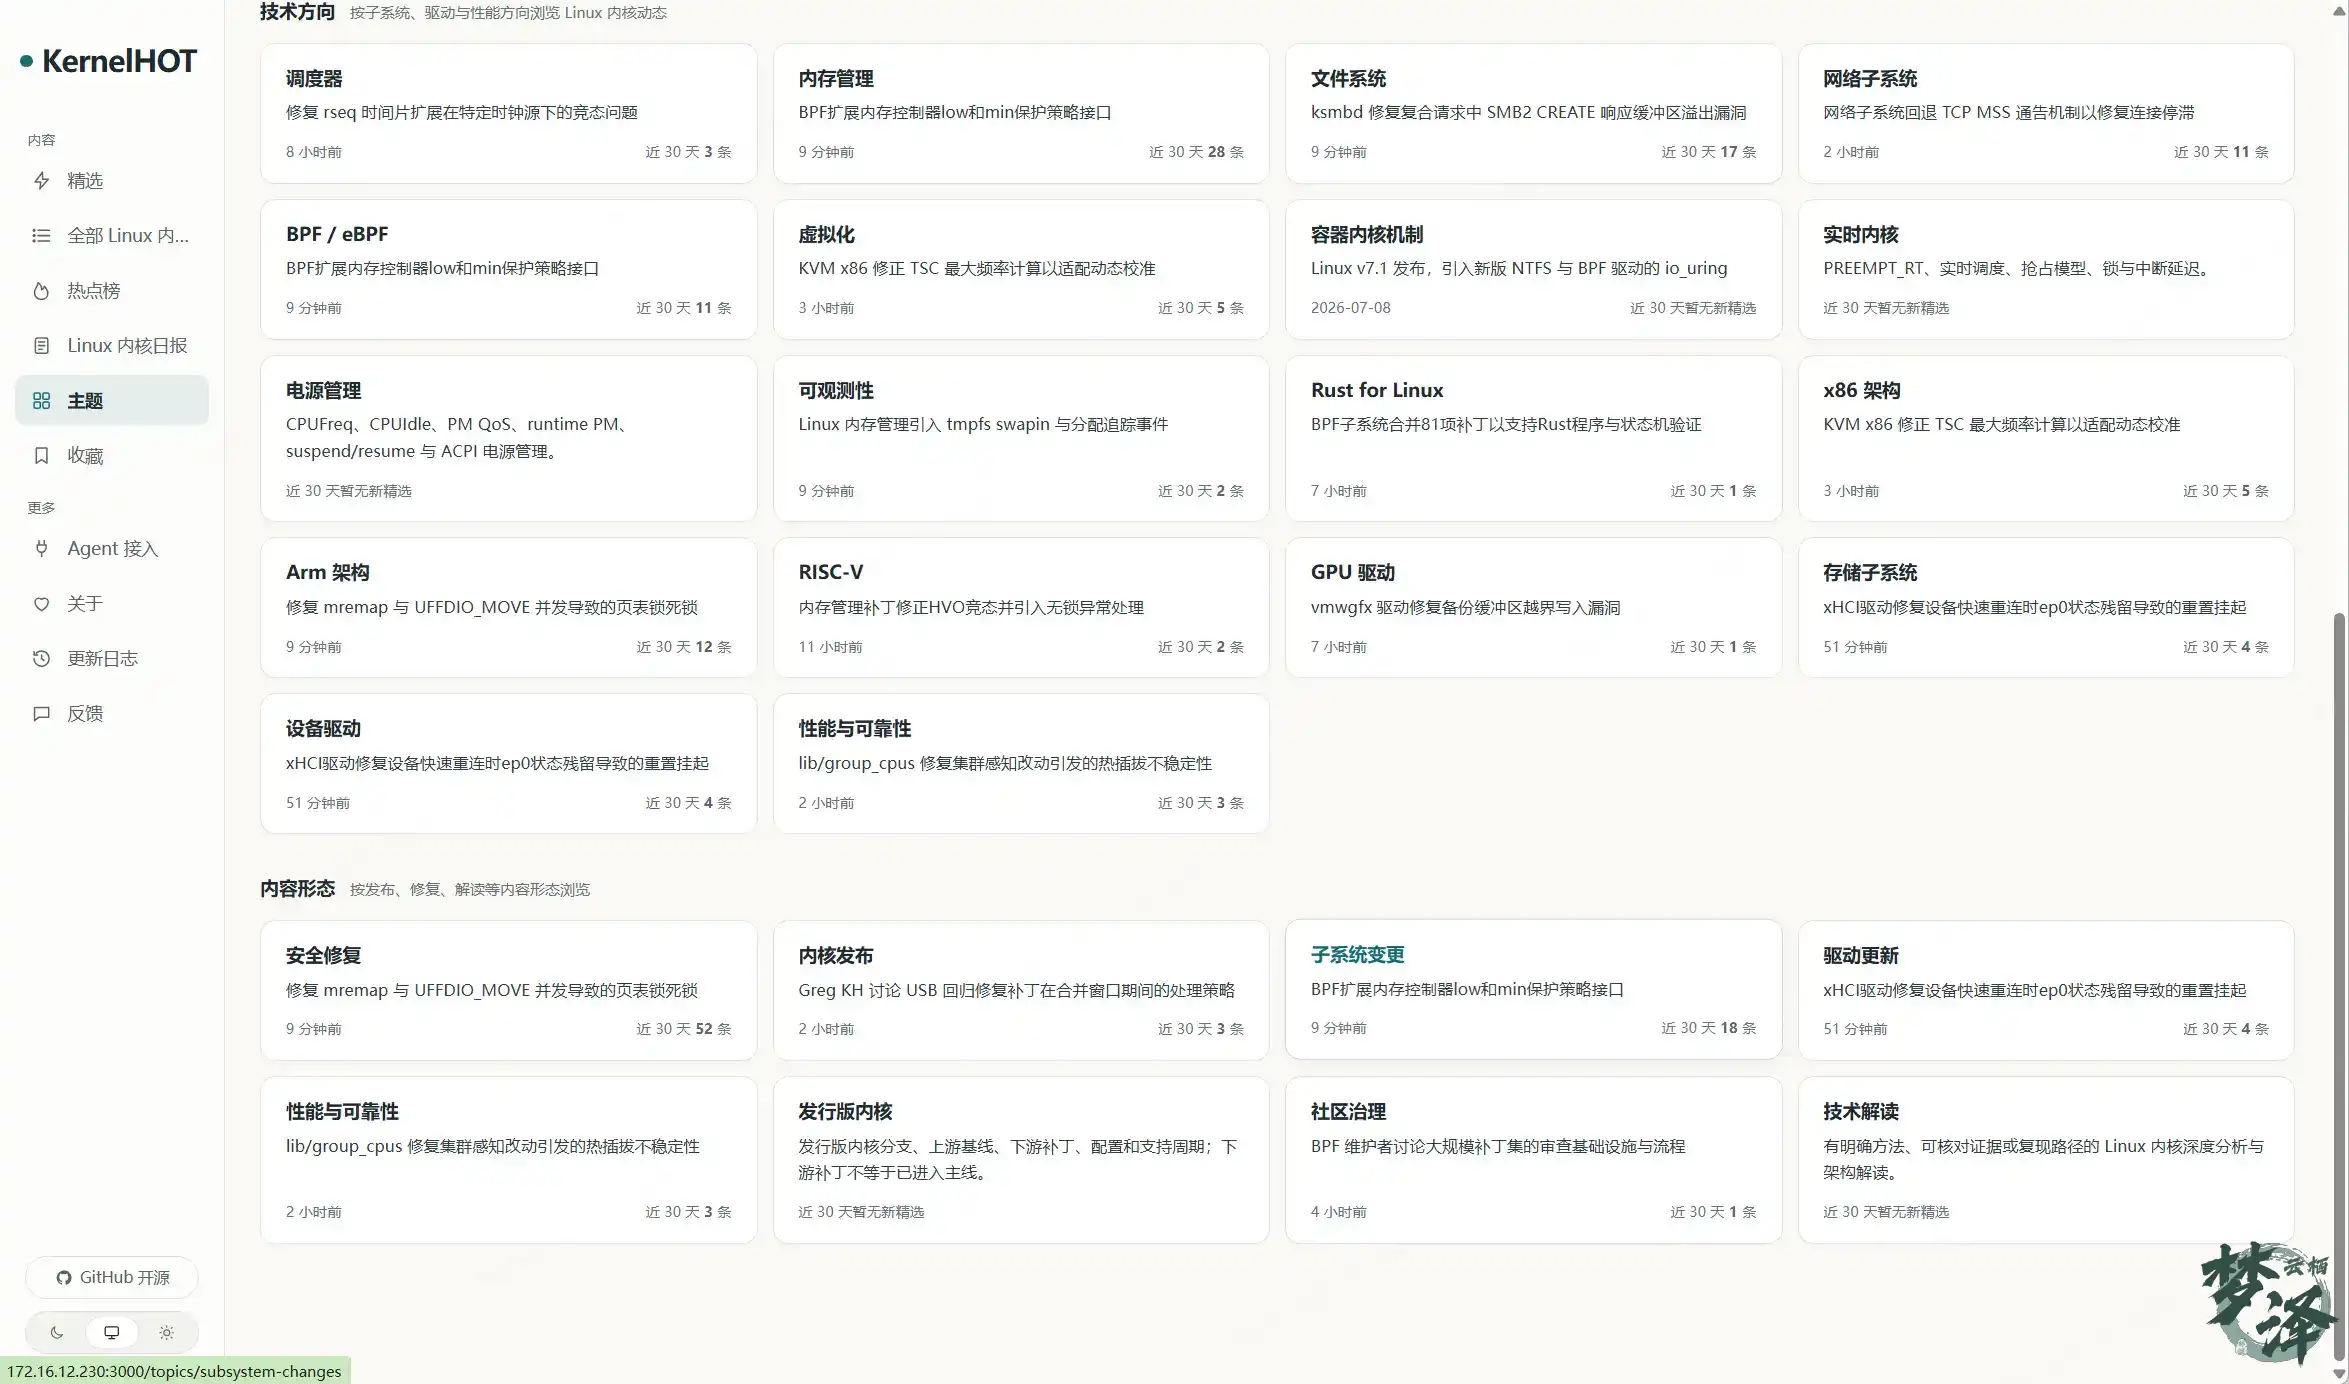
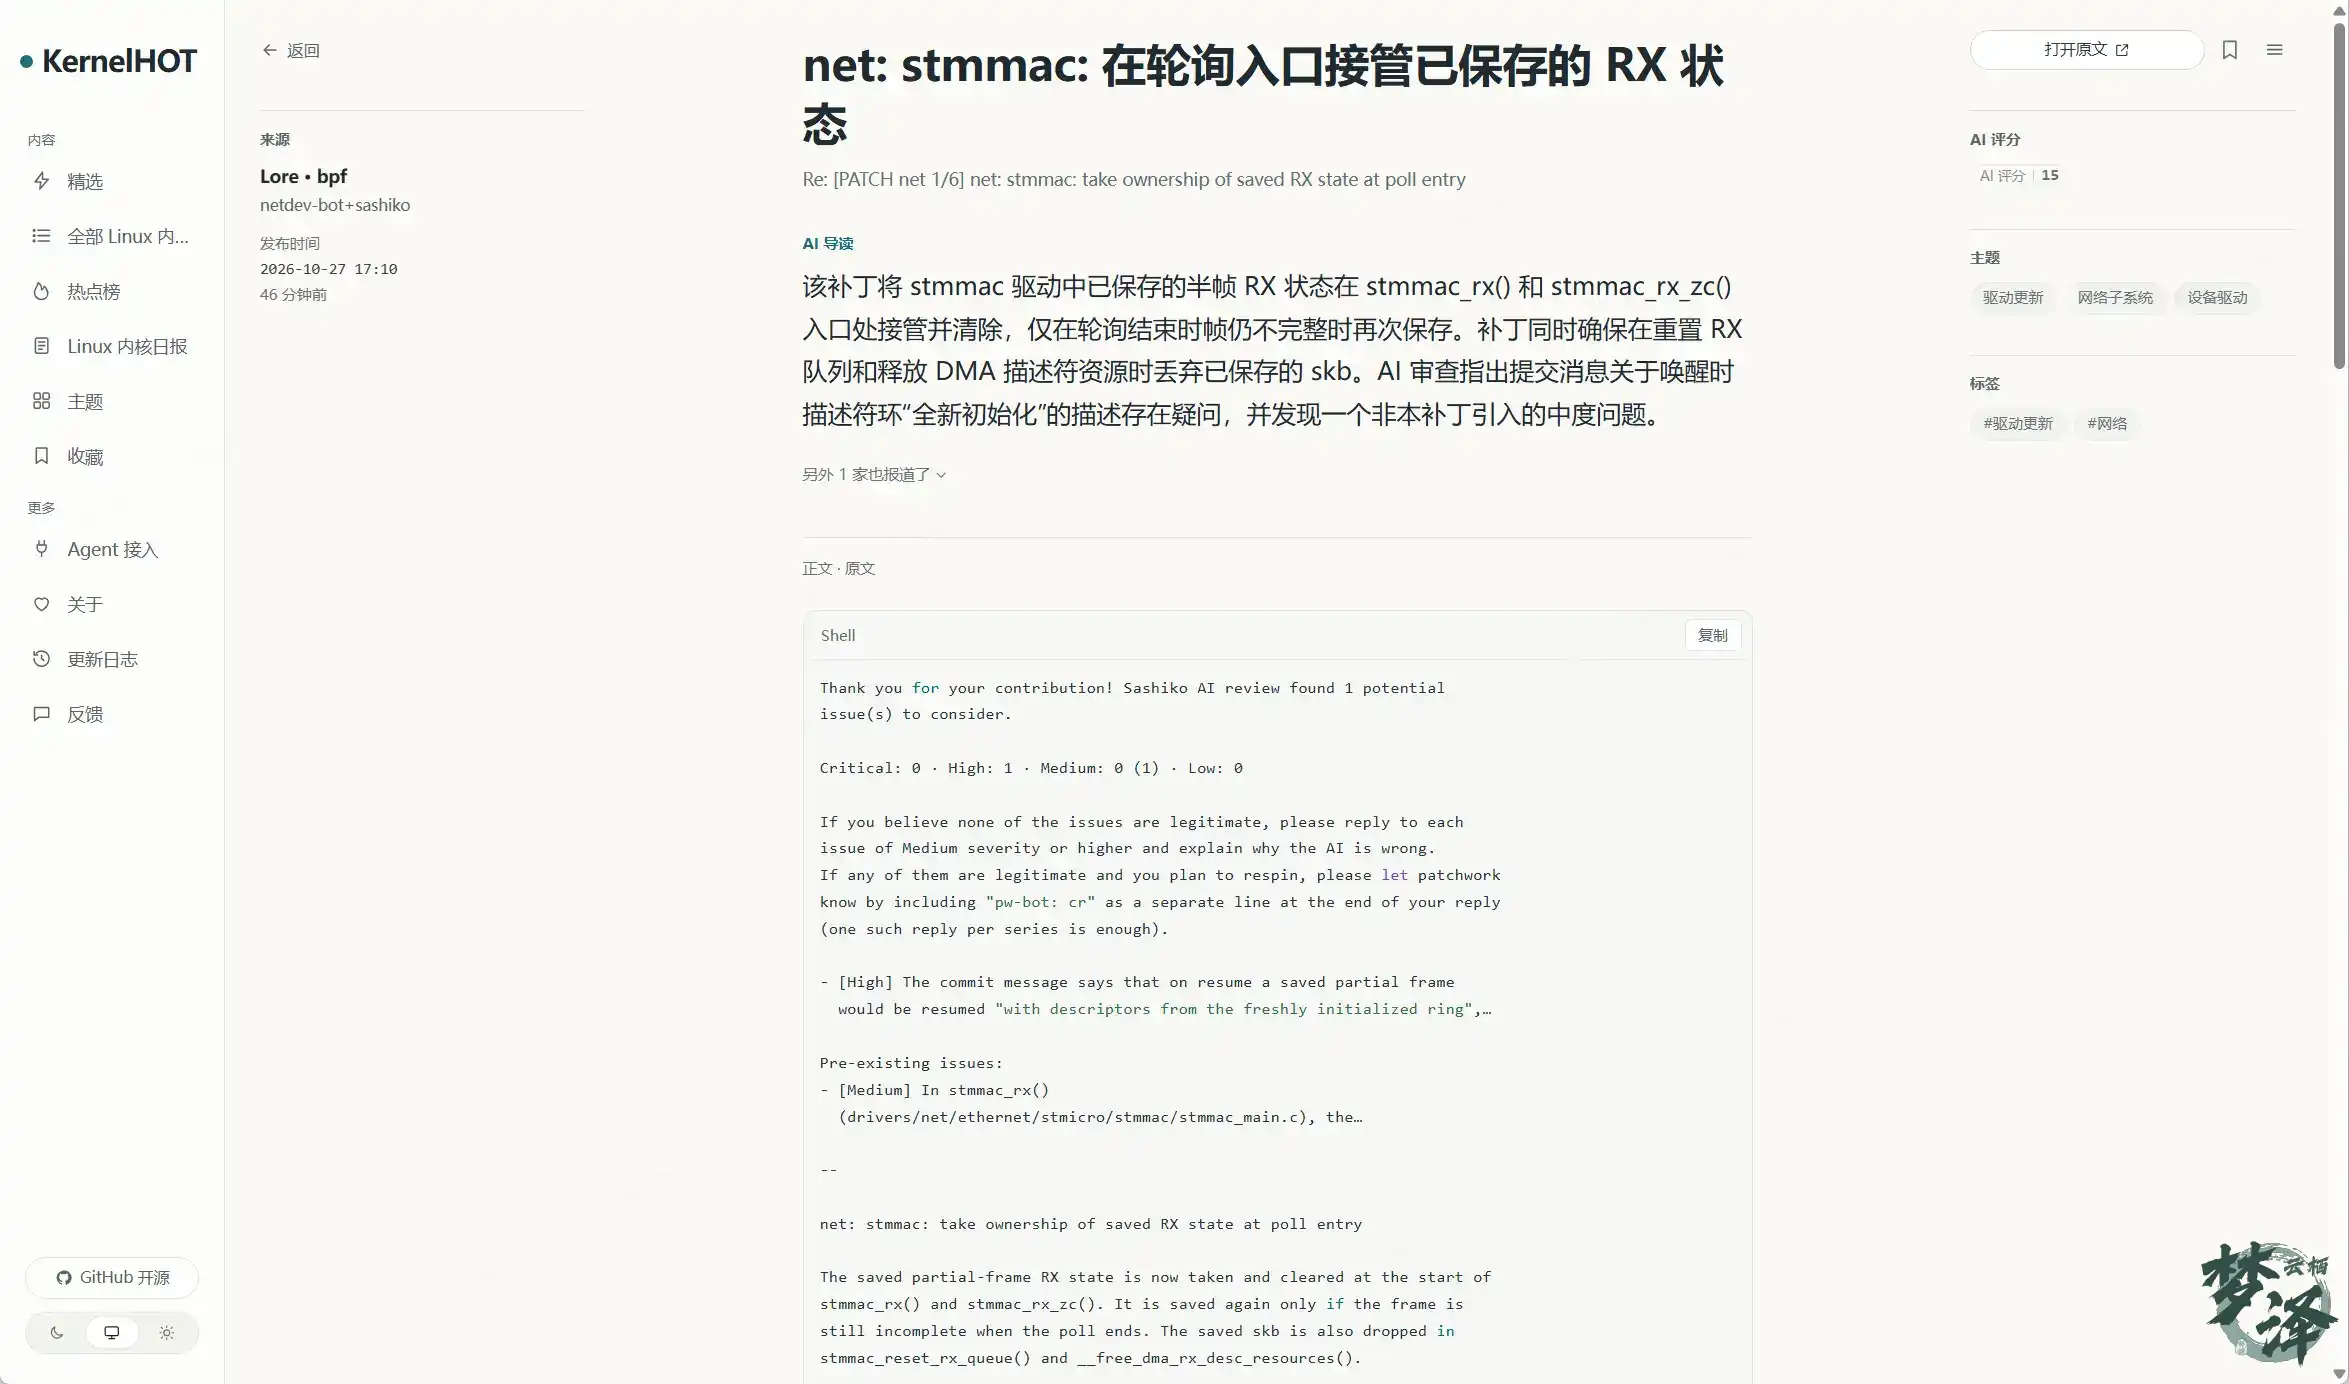
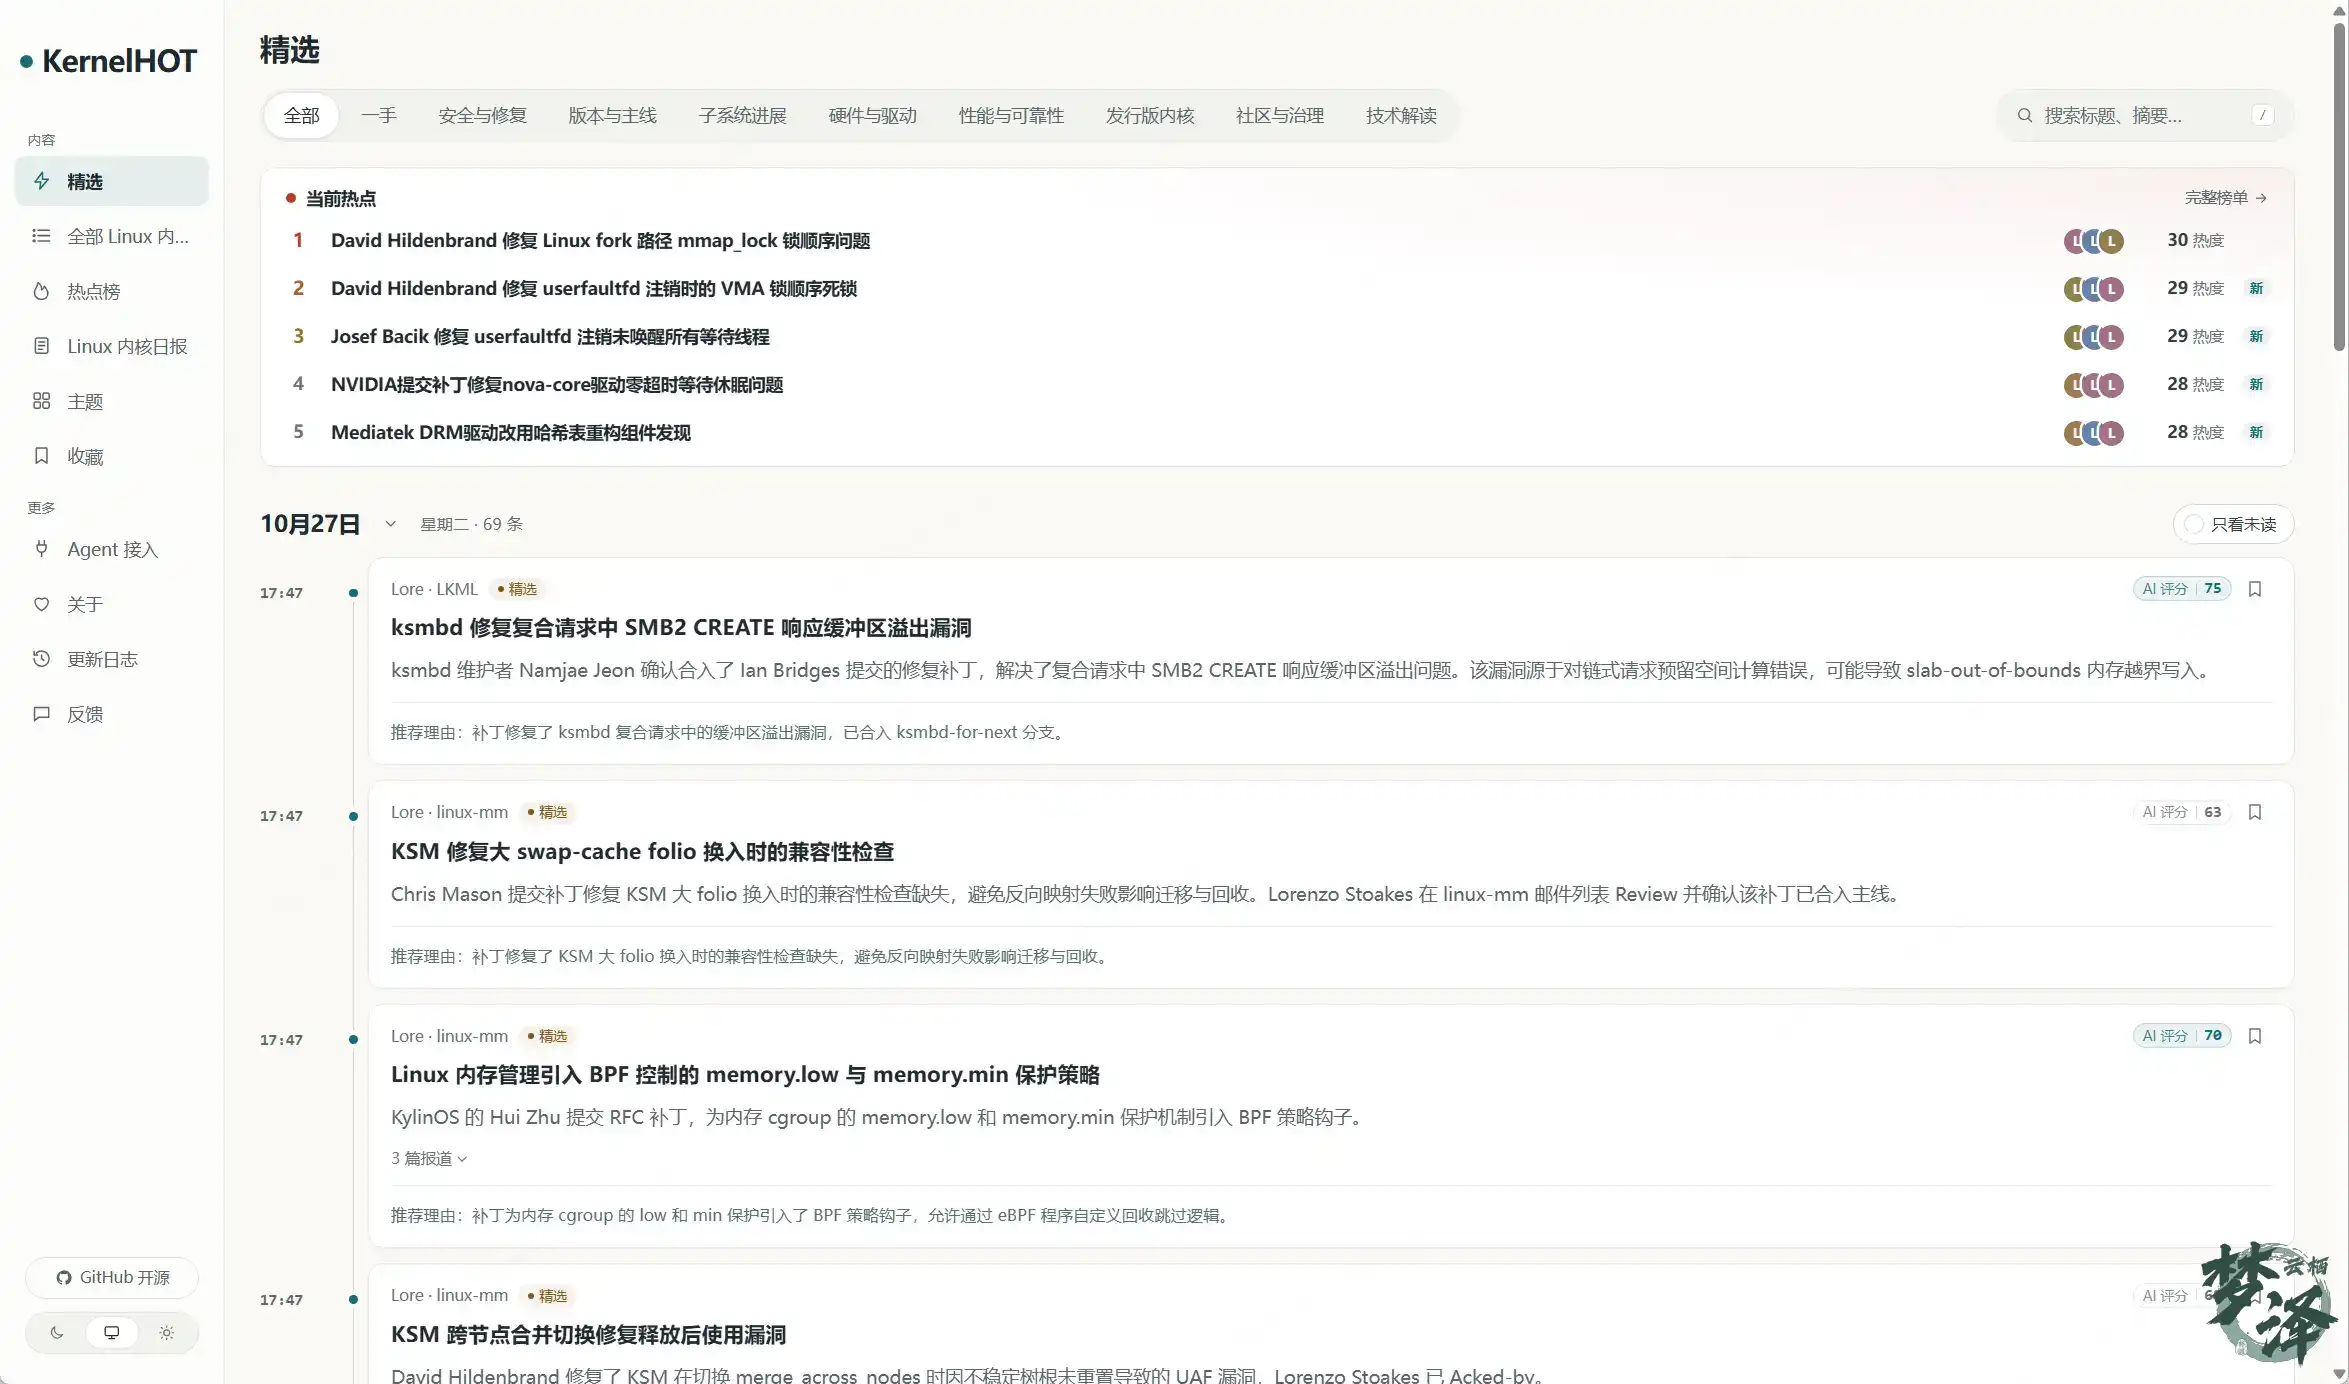
致谢
最后想特别感谢原作者「数字生命卡兹克」做的这个框架。
作为一个设计师出身、半年前还看不太懂代码的人,他和我一样经历过信息碎片化的焦虑。他做 AIHOT 解决了自己的问题,然后选择开源,让别人也能受益。他在 README 里写:
AIHOT 曾经只是我无数个深夜里,一个很小、很小的念头。我不知道它会被改成什么样子,会走到多远的地方。但这可能就是开源最浪漫的地方。
剩下的路,就交给用这个框架做出自己站点的人了。
本文发布于 KernelHOT 项目仓库。KernelHOT 基于 AIHOT 框架构建。