title: "Google AI Agents 挑战赛作品背后的 4 个工程模式"
source_url: "https://developers.googleblog.com/4-engineering-patterns-behind-the-strongest-ai-agents-challenge-submissions/"
author: "Google Developers Blog"
excerpt: "公共早报 本文提炼出 Google for Startups AI Agents Challenge 获奖作品中的四大关键工程模式:双向 MCP 工具暴露、事件驱动并发、一致的回退验证,以及分层路由以降低推理成本。"
 我们刚刚结束了 Google for Startups AI Agents Challenge,来自全球的数千名开发者提交了他们的 Agent 项目,评审团对三个赛道的作品进行了评分。
"多智能体系统"可能是提交作品中出现最频繁的说法,但仔细审视后,其中一些确实构成了真正意义上的复杂多智能体解决方案,而另一些则只是一个模型在处理一连串提示词,只是给每个提示冠以 Agent 的名字。
不过,在各赛道实际排名靠前的作品中,始终可以看到一些相同的工程决策和模式。以下是其中的四个,非常值得你在自己的项目中借鉴。它们源自真实的代码提交,且在描述时隐去了团队名称,因为这不是为了吹捧某一支队伍。
双向 MCP: 一个 Agent 既是自己工具的调用方,也是可供其他 Agent 调用服务器。
事件驱动并发: 多个 Agent 对同一信号做出并行响应,而非在调用链中彼此等待。
同等标准的回退方案: 用一个较小的模型替代超负荷的模型,而无需降低质量检查标准。
分层路由: 在模型介入之前,先运行廉价的确定性检查。
模式一:为你自己构建的工具,同样可以为其他 Agent 服务 {#模式一:为你自己构建的工具同样可以为其他-agent服务}
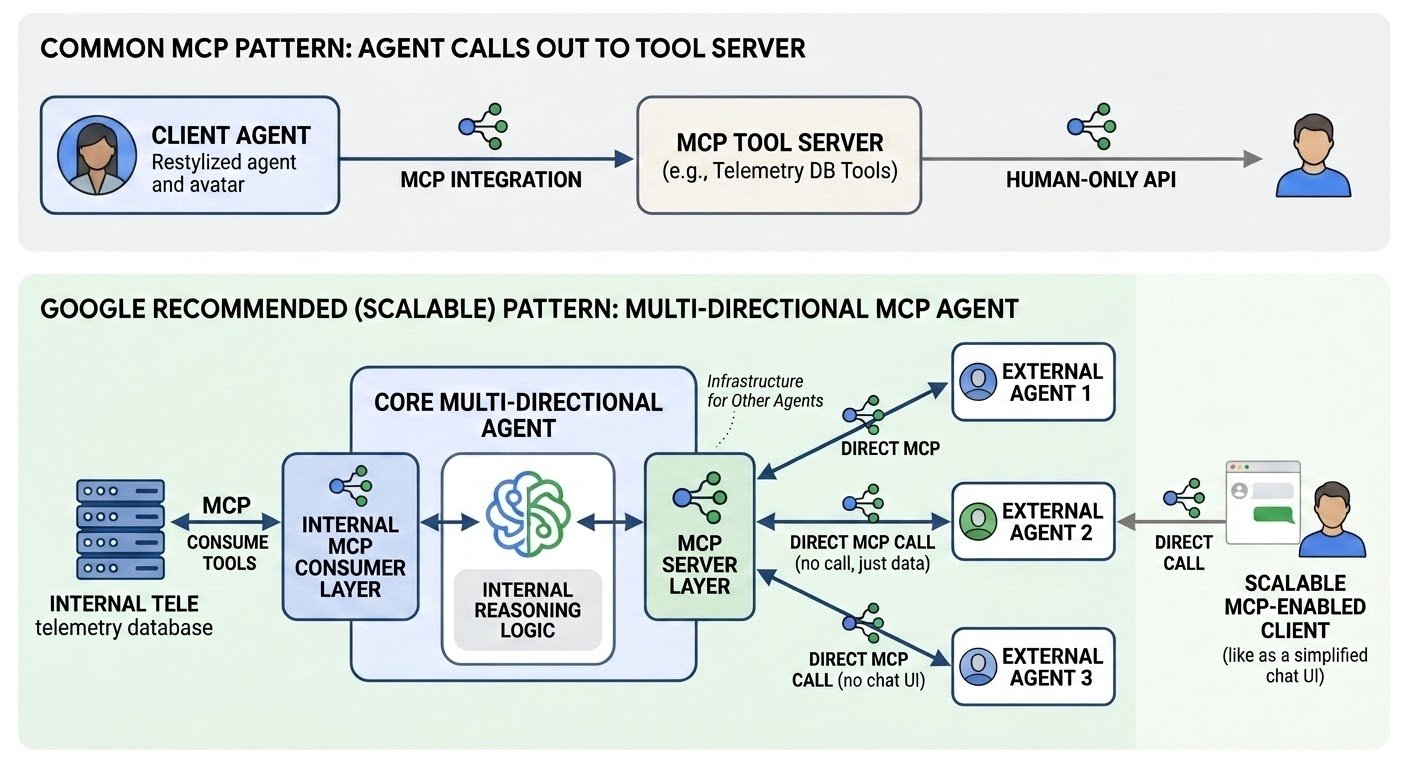
大多数提交作品对 MCP 的使用是单向的:Agent 调用工具服务器来获取数据。然而,有一支团队将其扩展为双向。它们的 Agent 内部通过自身的 MCP 工具层来消费遥测数据库,随后又将同一套推理能力作为 MCP 服务器暴露给其他 Agent 调用,使另一个 Agent 能够直接向它提问,无需为人类构建聊天界面。
在没有考虑外部调用之前,内部这一半本身就很有价值。这个 Agent 的朴素版本可能是对遥测库执行 SQL 查询,然后将每一行数据直接倾倒到模型的上下文中——在真实的生产数据库上,这样一次请求就会耗尽你的 Token 预算。通过 MCP 工具层访问意味着 Agent 获得了以编程方式检查和过滤数据的工具,只拉取作业的执行计划或特定的堆栈跟踪,而不是整个表,从而使上下文保持足够小以进行实际推理。通过工具中介数据库访问而非原始连接,这也是外部模式得以实现的前提。暴露一个只返回有限、目的明确的答案的工具是安全的,可以交给不受控的调用方,而原始 SQL 连接则永远无法做到这一点。
这就是改变产品形态的关键决策。一旦 Agent 自身的推理已经架设在工具接口之后,向外部暴露它只需要在该工具前架设一个 MCP 服务器。在这个案例中,这意味着在终端或 IDE 中工作的编码 Agent 可以直接调用性能 Agent 并询问特定作业,就像调用任何其他工具一样。人类无需打开仪表盘、在聊天框中描述问题,再将答案复制回自己的workflow。聊天界面是一个终点,而 MCP 服务器可以成为其他 Agent 构建的基础设施,无需任何人为其再写一层集成。
容易被忽略的一点是:一旦你服务的是不受控的调用方,该服务器就需要真正的访问控制。任何能够访问它的人现在都可以直接调用你的推理层。一个只被你自己的 Agent 调用的工具面不需要考虑这一点,而外部可调用的工具面则必须考虑。
今日行动: 如果你的 Agent 已经在内部通过 MCP 与自己的数据通信,看看将这些工具暴露给外部需要额外多少工作,而不要去构建第二个只面向人类、且做同样事情的 API。
模式二:让 Agent 并行响应同一事件 {#模式二:让-agent-并行响应同一事件}
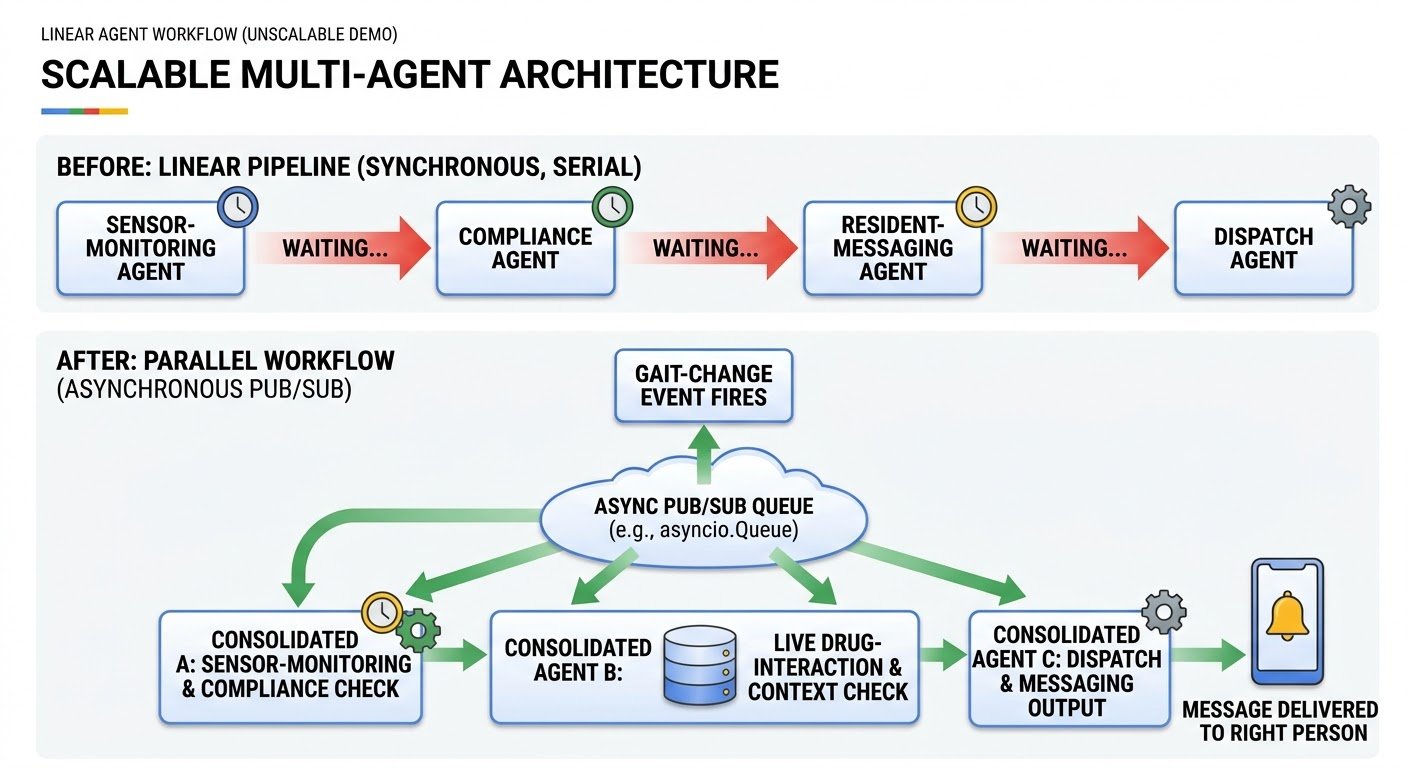
有一支团队的第一个版本是一条线性流水线:一个传感器监控 Agent 调用合规 Agent,合规 Agent 调用居民消息 Agent,居民消息 Agent 再调用调度 Agent。作为 Demo 效果很好。但在真实用例中就崩溃了:从步态变化中捕捉跌倒风险,将其与实时药物相互作用数据库交叉比对,并在行动窗口关闭之前将消息发送给正确的人。
解决方案是构建在四个独立的 asyncio.Queue 实例上的异步事件总线,每个 Agent 一个,每个实例都有自己的 worker 协程从中取数据。Agent 不再是调用另一个 Agent 并等待返回值,而是将带类型的事件发布到命名主题,并订阅自己关心的主题。步态速度下降 15% 或更多就会发布一个 CLINICAL.ANOMALY_DETECTED 事件。合规 Agent 已经在该主题上"停车"了,所以它会在事件触发的瞬间立即获取事件,将其与药物相互作用数据库交叉比对,并在完成的瞬间发布自己的 CLINICAL.COMPLIANCE_REPORT_READY 事件——不是基于轮询间隔,不是在等上游显式地进行交接。消息 Agent 和调度 Agent 在下游以同样的方式工作,每一个都是被其订阅的主题唤醒,而不是被前一个运行它的 Agent 直接调用。
这就是调用链与事件总线的真正区别:在调用链中,总延迟是累加的,Agent 一的时间加上 Agent 二的时间再加上 Agent 三的时间,因为每个 Agent 都在占用栈空间等待下一个。基于主题的总线则不同,两个输出互不依赖的 Agent 可以同时运行,因为彼此都不会阻塞对方的返回。当你的 Agent 运行在完全不同的节奏上时,你希望看到的就是这种形态:一个每隔几秒轮询一次,一个发出需要半秒的网络调用,一个只在最后才触发一次。把所有这些串进一个调用栈,你最快的 Agent 仍然会被最慢的那个拖累。
今日行动: 检查你的两个 Agent 是否曾经需要响应同一个信号。如果你的架构让一个等另一个完成才能行动,那它就是一个披着多智能体外衣的单线程系统。
模式三:回退模型同样必须达到你的标准 {#模式三:回退模型同样必须达到你的标准}
另一支团队的临床推理 Agent 运行在 Gemini 3.1 Pro 上。在真实负载下,Pro 开始返回 503 错误。其他大多数参赛作品可能只是针对同一模型加上重试循环然后作罢。但这支团队构建了一个回退方案:使用 Gemini 3.6 Flash 并配合退避策略,然后无论哪个模型返回的响应都必须经过完全相同的验证函数才能被接受:该函数会进行引用检查,确认答案确实引用了真实的临床指南,而不仅仅是听起来合理的医学用语。
这里值得借鉴的细节不是回退机制的存在,而是验证逻辑放在哪里。验证不是在主路径和回退路径各放一份——那样很容易更新了一个副本而忘了另一个。只存在一个 validate_clinical_response() 函数,Pro 路径和 Flash 路径在结果离开 Agent 之前都必须调用它。一旦响应进入该函数,无论哪个模型生成它都不重要,两个模型都没有捷径可走,也不会因为碰巧在请求到达时是可用的那个模型而发出一个未通过检查的答案。
这就是真正防止回退方案悄悄降低标准的方式:不是记住要应用两次相同的标准,而是从结构上让它不可能只应用一次。
今日行动: 找到回退触发后运行的代码路径。如果它跳过了主路径所拥有的验证步骤,你实际上在交付两种不同的产品,却只测试了其中一种。

模式四:在昂贵的调用之前进行分层路由 {#模式四:在昂贵的调用之前进行分层路由}
推理成本可能是目前 AI 领域讨论最多的制约因素:每个人都想要前沿模型的推理能力,却不想为每个请求都支付前沿模型的价格。这正是我们在本轮生产环境中实际看到有效的成本模式之一。
有一支团队测量了到底是什么在消耗他们的推理预算,发现不是难题,而是简单问题:"我的订单在哪"、"取消我的预约",这些与真正模糊不清的请求走的是相同的完整模型调用。他们的解决方案是在 Agent 前加了一个三层分类器:本地正则表达式通关以零 Token 捕获导航意图,模糊情况以 10 Token 和 temperature 0.1 调用一次廉价的 Gemini 调用来分类意图,只有同时通过这两层的内容才会到达完整推理模型。据他们自己测量,仅第一层就处理了超过 40% 的传入消息,在此之前从未发生过真正的模型调用。另一个参赛作品将同样的思路应用在不同的流水线上:一个快速、廉价的模型对传入案例进行门控和分诊,只有需要深度推理的才会升级到一个更慢、更贵的模型。不要在你更便宜的模型已经能够做出决策的地方花费最贵的模型。
今日行动: 在你以为需要更大模型之前,先看看你自己的流量分布。更便宜的第一关通常能让你走得更远。
 回顾本轮挑战赛,基于 Agent Development Kit (ADK) 构建、并通过 Agents CLI 驱动的作品是这些模式出现最频繁的,主要原因是该框架不会在并发、回退或向其他 Agent 提供工具方面给你添堵。
在这四种模式中,没有任何一种真正需要更大的团队或更新的模型。它们代表的是经常被忽视的可靠工程实践。而且它们可以很好地组合互补。有一支格外引人注目的团队在同一个项目中同时结合了模式一和模式三:一个根 Agent 将专家 Agent 并发地分派出去,然后将整个推理层作为 MCP 服务器暴露给其他 Agent 直接调用。
这就是我们在下一轮中将要寻找的标准:一个遵循这四种模式的系统。但你不需要为了参加挑战才去使用它们。将这些模式应用在你的下一个项目中吧。