title: "Meta 组织级第二大脑:构建从专家学习的 AI"
source_url: "https://engineering.fb.com/2026/09/02/ml-applications/organizational-second-brain-ai-learns-from-experts/"
author: "Engineering at Meta"
excerpt: "公共早报 Meta 将专家知识与推理流程分开组织,再把专家反馈编译为经过回归测试的修订,无需重训模型;团队报告单次评估从数天缩短至数分钟,改进周期内未出现回归问题。"
我们构建了一个 AI agent,它充当给定领域的第二专家,使深层专业知识随时可供组织中任何人访问、共享和构建。
这不是一个典型的领域特定 agent。它的创新之处在于整合了两层:
一个结构化的、可审计的知识架构,将 agent 知道什么与它如何推理分开。
一个自我改进循环,然后将专家反馈编译为经过验证的、回归测试的更新而无须重训模型。
这两层共同将一次性的专家纠正转化为永久的、复合的制度记忆,并且该模式被设计为可以泛化到其他由可检索文本而非模型权重支配的领域。
该系统为 Meta 的领域主题专家(SMEs)节省了大量时间,使他们能够更多地专注于他们的知识最重要的领域。
许多大型组织在专业知识方面都有相同的问题。虽然其中一些以模型、手册、检查清单和框架的形式写成文字,但最有价值的专业知识存在于人们的头脑中,很少被持久地捕获。例如,在合规领域,相同类型的问题可以在数百次产品审查中出现,专家评估需要数天的手动研究,评估之间的不一致造成真正的组织风险。
专家花更多时间回答常规问题而不是真正新颖和模糊的工作(他们的判断最重要的地方)并不罕见。我们需要能够捕获组织专家如何推理并使该知识可供每个需要它的人使用的系统,这样专业知识更容易共享、构建和保留。
我们通过将制度智能编纂成一个针对特定合规领域的 AI agent 来解决这一挑战。该 agent 结合了一个充当组织「第二大脑」的知识系统、一个镜像领域专家实际思考方式的推理层,以及一个永久复合专家努力的自动化改进 pipeline。这些模式泛化到任何具有深层专业知识的企业领域,无论是金融、安全还是工程。
架构一览
现成的 LLM 提供了强大的基础,但它们通常需要更深入的制度背景才能在专业领域完全有效。没有这种 grounding,通用模型的价值有限,因为它无法区分组织可以做什么(一般信息的摘要)和应该做什么(基于历史立场、公司方向、业务背景等)。在高风险领域,缩小这一差距需要为模型提供组织自己的知识和优先级,以便其分析反映组织实际的推理方式。
我们设计的系统有四层,每层解决一个不同的问题:
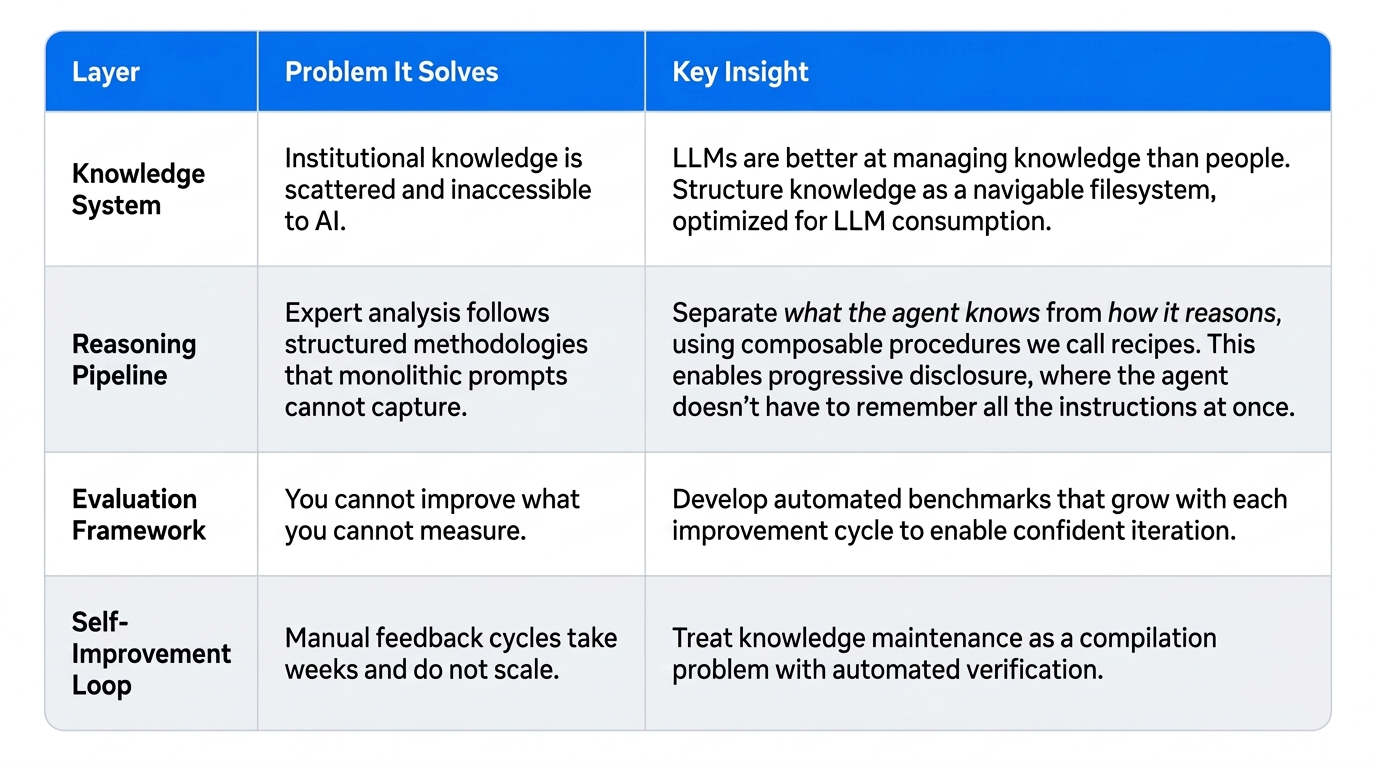
这些层相互依赖。知识系统的文件结构使自动化编辑成为可能。推理层的显式程序使失败归因变得可追溯。评估框架把关每一次变更。改进循环反馈到知识和推理中。移除任何一层,其他层都会退化。
大型组织可以积累数千份文档作为专家工作的副产品。将这些文档视为组织知识很诱人,但真正的知识是隐式的:专家如何推理,他们优先考虑什么,他们如何解决歧义。在推理时检索文档块的 agent 必须在每次运行中从原始来源重新派生该推理,这很慢、容易出错且不一致。
我们在运行之前使隐式知识变得显式。一个长期运行的离线过程会推理源文档并将它们提炼为结构化知识文件——关于组织如何解释其领域的精选陈述,使约束、边界和路由含义可被机器读取。
最重要的是,这些知识然后形成一个反馈循环的基础,允许 agent 从人类专家那里学习并实施反馈,而无需底层模型必须被重训。
业界已经 convergence 在一个类似的想法上。Andrej Karpathy 的 LLM Wiki 将 agent 知识结构化为可导航的文件图,Google 的 Open Knowledge Format 为跨 agent 互操作性标准化了这一点。共同的见解是,知识应该被预先提取、显式结构化并渐进披露,而不是在每次查询时重新派生。我们将这些原则扩展到一个 citation 保真度和制度一致性是不可妥协的系统,将 200+ 个文件组织成严格的分类法:
立场文件捕获权威的组织立场:组织如何决定解释给定的领域问题,以及其约束、边界条件和对推理层适用的机器可操作路由含义。
分类法和词汇文件充当组织用来描述其领域的术语的权威词汇表,例如实体类型、活动类别和分类层级。每一个都维护为单一真实来源,以便 agent 和组织一致地使用语言。
路由索引将输入特征映射到相关立场和程序,确定哪些文件适用,而不单纯依赖 embedding 相似性。这使检索具有确定性和可审计性。
网关文件定义 agent 在进入分析领域之前必须通过的阈值测试,阻止它在其不适用之处应用专门知识。
每个文件在 YAML frontmatter 中声明其依赖项(depends_on)和消费者(referenced_by),形成双向依赖图。当一个文件更改时,你可以准确追踪可能影响的其他内容,这在自我改进循环提出自动化编辑时很重要。
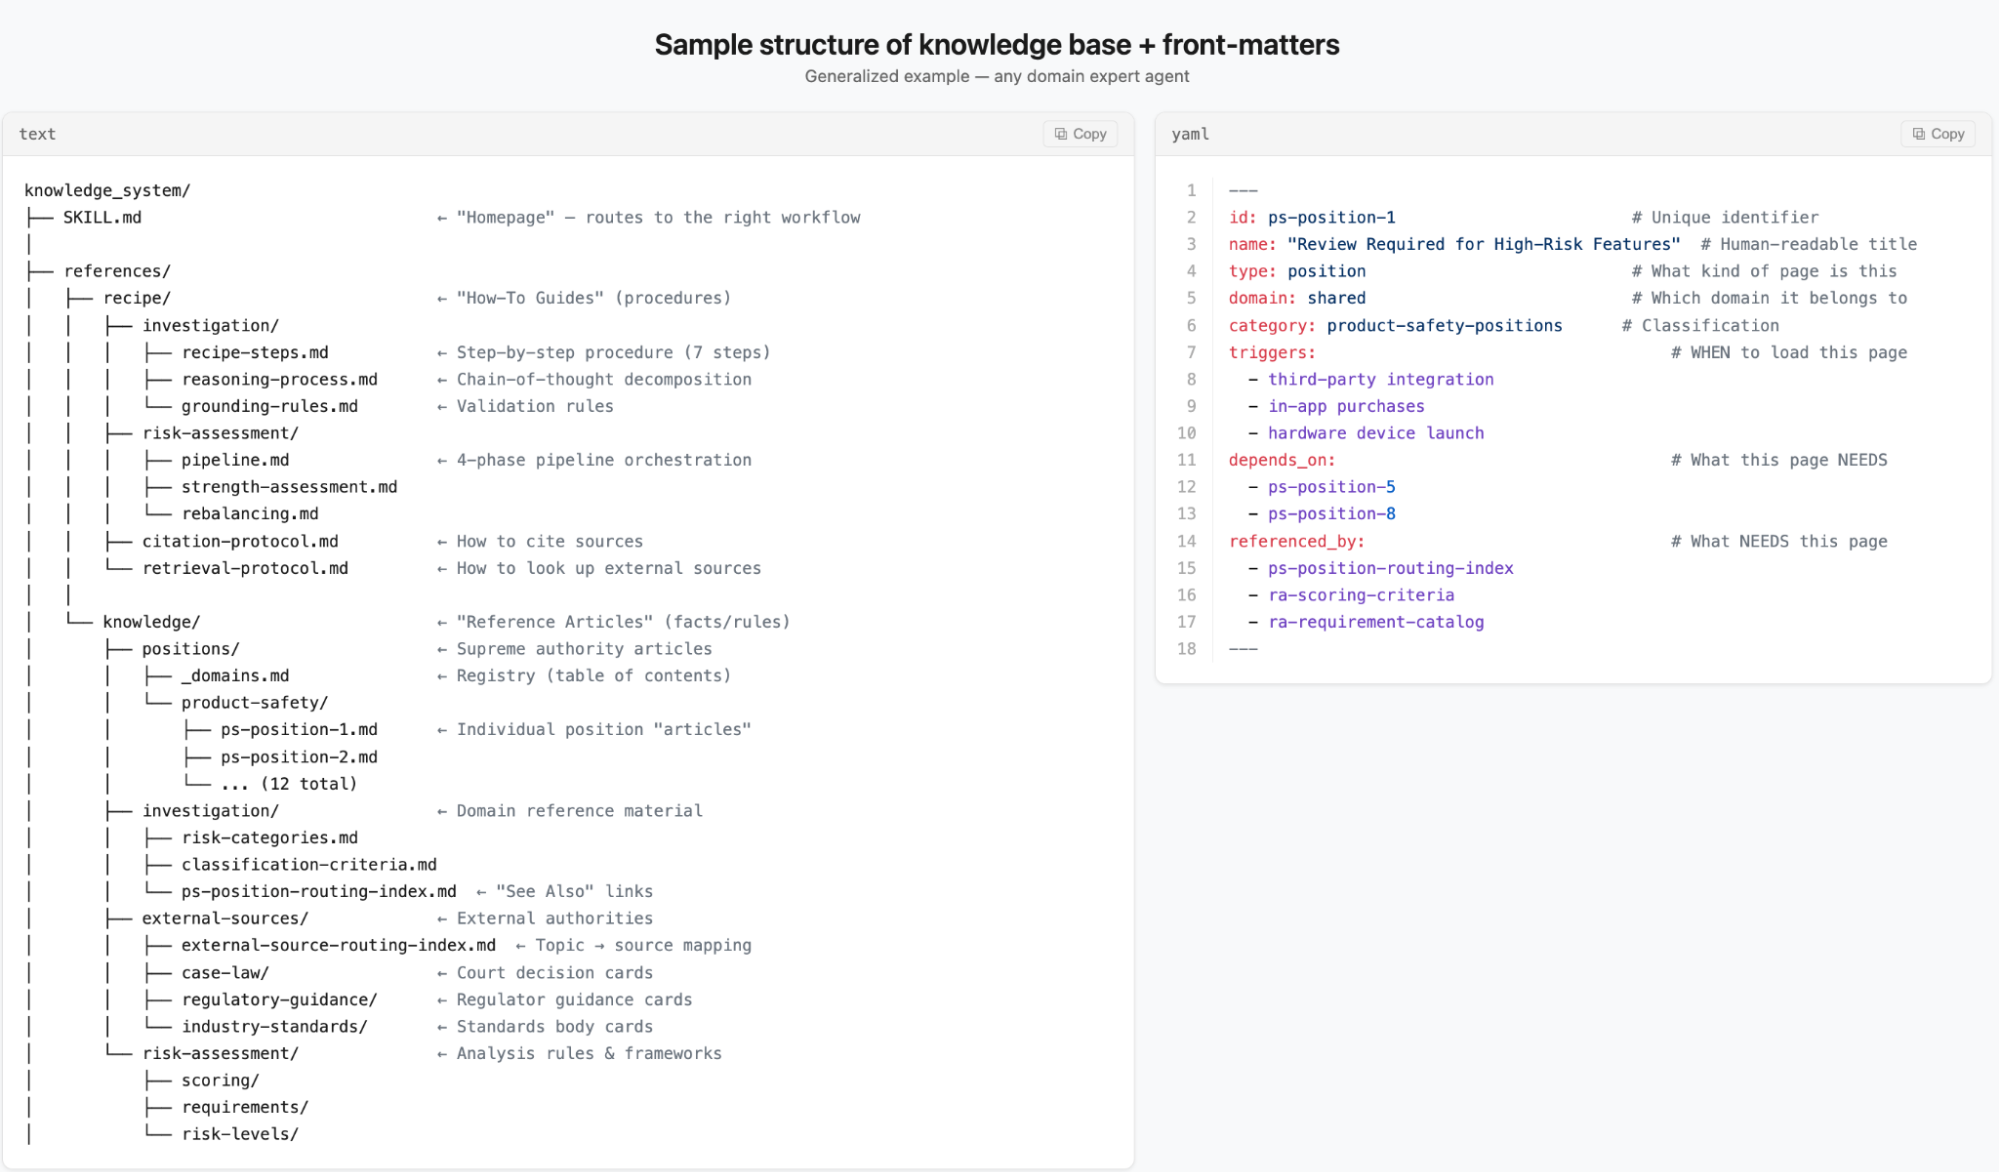 知识系统的图示:文件被组织为可导航的文件系统(左),每个文件的 YAML frontmatter(右)声明其适用时间(触发场景)及其依赖项和消费者,形成 agent 可以轻松遍历和维护的双向依赖图。
按密度和使用频率组织知识
一个关键的架构决策是如何在策展 wiki 和补充检索(RAG)之间划分知识。我们按信息密度和预期使用频率进行 split。
高密度、频繁引用的来源进入 wiki:** 提炼文件捕获组织推理方式,例如立场、决策框架、边界示例和战略解释。agent 在几乎每次 turn 中都会查阅这些。因为它们编码了组织不断发展的思维,所以需要保持最新,而 wiki 结构使它们易于更新、版本控制和验证。
稀疏的、情境相关的来源通过语义或词汇搜索(RAG)提供:这些文档在适用时很重要,但在大多数运行中不需要详细细节,例如详细参考材料单独产品规格、历史决策记录和小众外部知识。将所有这些加载到 wiki 中会使系统臃肿并稀释注意力。
结果是 agent 的核心推理始终基于最精炼、最新的组织知识,同时在场景需要时仍能获取支持证据。这种组合产生了一个组织第二大脑,它编码了组织如何解释和应用信息,而不仅仅是去哪里找到它。
通过可组合配方进行专家推理
仅有知识是不够的。领域专家不仅仅是回忆事实,他们遵循结构化方法:金融分析师逐步完成估值模型,安全工程师遵循威胁建模程序。挑战在于以 LLM 可以可靠执行的形式捕获这些方法。
我们用我们称之为配方的可组合程序来解决这个问题。知识文件是声明性的,配方是命令性的。每一个都规定了多步骤分析工作流程,指定首先检查什么、在每一步加载哪些知识、遵循什么决策程序,以及什么构成完整分析。
关键的设计选择是将 agent 知道什么与它如何推理分开。配方引用知识文件但不包含领域事实;知识文件陈述立场但不规定程序。这意味着:
添加组织立场意味着添加知识文件并更新路由索引。配方不变。
修复 agent 方法中的缺陷意味着编辑配方。知识文件不变。
失败干净地归因于一层。是知识错了,还是程序错了?
配方组合成 pipeline,就像行政总厨的主配方将晚宴服务委托给每个组件的子配方(酱汁、蛋白质、配菜),而不包含那些细节本身。我们的顶级路由配方检查输入并选择调用哪些下游配方,每个配方处理一个分析阶段。
这也正是渐进披露的实现方式。不是预先加载一个涵盖每种可能场景的单一整体指令集,而是每个配方步骤只携带与该阶段相关的指令和知识。早期版本使用单个平面指令文件,并通过语义搜索加载所有来源,在每次运行时将大量混合相关性的文件拉入 context window。重组为配方驱动的阶段后,每次查询只触及一小部分针对性内容,将每次 turn 消耗的 token 减少约 80%。Context window 是有限的,注意力随 volume 下降,所以在正确的时间提供正确的指令直接改善推理质量。
保持人类在控制之中
人类专家在整个系统中保持控制。Agent 加速并构建了他们的工作;它不取代他们的判断或他们对结果的所有权。
我们通过两种机制来执行此操作:
检查点是分析中定义的点,agent 在此 surf 其中间推理以供专家在继续之前进行审查,专家可以确认、纠正或重定向。
上报在 agent 遇到真正歧义时触发,无论是源于输入不明确还是支持多种合理解读的证据。它不是强制 resolution,而是将问题交给专家,其选择决定了分析所采取的路径。
检查点和上报同时服务于三个目的:
质量和方向控制: 专家在他们传播到下游之前捕获错误,并使分析保持在他们认为最相关的路径上。
训练信号: 每次纠正和每次上报都成为自我改进循环的输入。
信任校准: 专家通过观察 agent 的推理而不仅仅是其最终输出来逐步建立信心,并且通过看到它标记不确定性而不是掩盖它来建立信心。
决策越重要,这就越重要,这就是为什么我们建议默认在合规、财务风险评估、安全审查和工程安全等领域保持人类在循环中。
自我改进行飞轮
我们认为自我改进飞轮是系统最独特的部分。虽然结构化知识系统和可组合配方产生了一个对人类和 agent 来说都是可读的、可测试的、模块化的系统,但大量相互依赖的文件使手动维护无法扩展。当领域专家向 agent 提供反馈时,该反馈必须被翻译成精确的文件编辑。这个过程可能需要数周,因为它需要理解完整的依赖图,验证没有其他内容被破坏,并验证修复实际有效。
已有大量工作——从 RAG 记忆系统到模型权重知识编辑——致力于解决 agent 如何存储、检索和更新知识。但对于文档型制度知识库在增长和专家立场演变时保持正确,关注少得多。Auto-draft 自己修复的 agent 越来越常见;但我们没有看到在这种程度的验证严格性应用于结构化知识库而无需模型重训的情况。
我们将这种维护视为编译问题并使其自动化。每次专家纠正都要经过四个阶段:
将专家反馈诊断为可操作的问题及其根本原因。
将问题编译为最小的已验证编辑。
验证修复在无回归的情况下有效。
让领域专家审查它们。
循环完成后,回归测试套件用刚修复的问题进行丰富,以便未来的更新保留此行为。
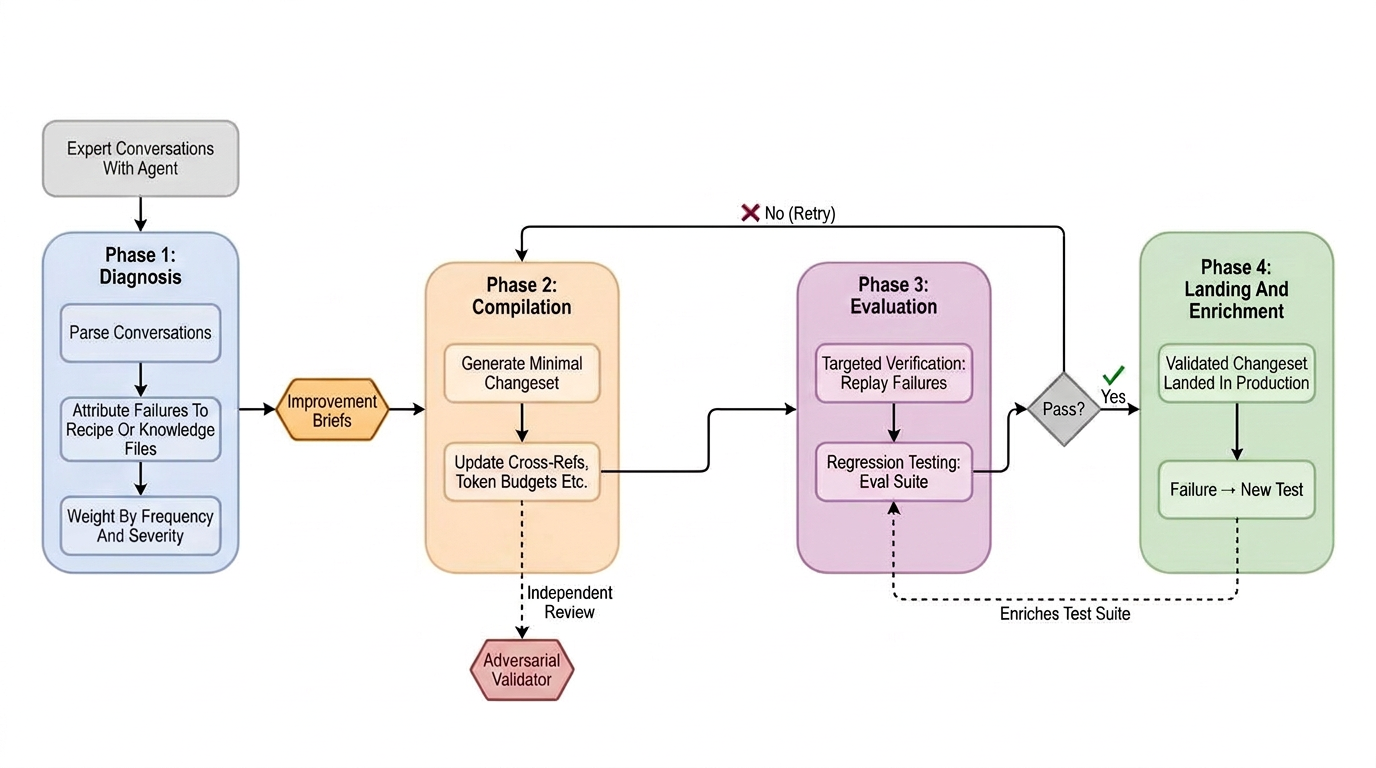 自我改进步骤。专家纠正被诊断出其根本原因,被编译为最小的已验证编辑,并在专家审查和落地之前根据重放和回归测试进行评估。每个修复然后被折叠回回归套件,因此收益是永久的。
诊断:将每次纠正归因于根本原因
原始专家反馈来自对话 traces,其中领域 SMEs 与 agent 交互并提供了纠正。诊断阶段从这些对话中提取结构化信号。
我们的第一种方法按对话形式对反馈进行分类。如果专家提供了信息,它一定是知识差距;如果他们重定向了 agent,那一定是程序问题。这种启发式失败了,因为对话形式是根本原因的糟糕代理。纠正结论的专家可能暴露的是知识差距、配方缺陷或真正的歧义。
工作的方法是分离提取和分类。首先,从专家那里提取每个实质性信号以及 agent 的完整知识清单(每个文件加载了什么、何时加载、如何使用)。其次,阅读实际的知识文件并应用单一归因测试:Agent 是否可能从其源材料中得到正确结论?
如果材料包含正确答案但 agent 仍然出错:配方问题。
如果材料不包含正确答案:知识差距。
如果专家自己不同意正确答案:歧义,标记为供人类讨论。
编译:精准的多 Agent 编辑
编译器将每个诊断出的 issue 翻译成最小的文件编辑。子 agents 并行分析影响,检查交叉引用、与现有立场的冲突、token 预算影响、测试覆盖率和重复风险。
两个设计选择使这变得可信赖:
独立的对抗性审查。 一个单独的 agent,在新的上下文中运行,对改进 rationale 一无所知,只接收对知识库 proposed diffs。它的任务是发现问题,例如引入的矛盾、被破坏的边缘案例或被削弱的立场。因为它与提出 agents 没有共享上下文,所以它不能继承他们的盲点。
确定性结构验证。 Linter 以编程方式 catch 问题:dangling 交叉引用、文件大小预算违规、标识符冲突和依赖循环。这一层不是概率性的。它要么通过,要么失败。
评估:证明修复有效
每个 proposed change 都经过两阶段验证:
针对性重放针对触发反馈的原始场景运行 agent。Agent 不知道自己正在被测试。一个单独的 judge 在不知道发生了什么变化的情况下,根据原始专家反馈评估新输出。这是刻意设计的 blind 格式,防止确认偏差。如果针对性重放失败,编译将重试。
回归测试运行该领域的多个基准,这些通常是结构化的问答对测试套件。对于可能有多个正确答案的分析领域,一个独立的 LLM judge 根据某些标准给每个测试用例一个通过/失败。Agent 以并行、独立会话的方式针对基准问题运行,并检测性能回归。如果回归测试失败,编译将用描述 agent 在哪里回归的更新提示以及原始 issue 和尝试的修复来重试。
落地与丰富:复合回报
Pipeline 的输出是一个带有完整审计 trail 的 pull request(diff)。人类专家审查的是一个经过验证的修复,而不是调试一个原始失败。一旦批准并落地(知识文件或配方被更新),原始失败场景及其经验证的正确答案被自动添加到回归测试套件中。这意味着每次修复都永久地提高了标准,未来对知识系统的更改必须保留刚纠正的行为。
结果
经过三个跨越六周的开发 sprint,系统实现了:
领域 SMEs 评估 agent 输出几乎总是有用的,这与早期版本相比有显著改进,早期版本输出经常需要大量返工。
单次评估时间从天缩短至分钟。
自动化自我改进以以前需要完整工程 sprint 的速度产生经过验证的知识编辑。
在改进周期中零回归,每次修复都自动加强回归套件。
领域专家一致报告 agent 处理了绝大部分分析工作,让他们能够专注于真正需要人类判断的模糊案例。
应用此架构
我们构建的这个特定领域需要将数十种来源(内部立场和外部材料)综合为风险加权评估。但架构是领域无关的。它适用于以下任何地方:
专业知识作为部落知识存在于专家头脑中。
评估之间的一致性很重要。
工作量超过可用专家容量。
现成 LLM 产生不充分的分析。
此模式适用的具体领域包括监管合规性、协议遵守、财务风险评估、安全审查、工程标准合规性和采购评估。共同的主线是组织需要具有真正制度专业知识的 AI 系统,而不仅仅是通用知识。
采用此架构的要求是:
一个结构化知识系统,具有明确的文件边界、交叉引用和依赖图(该领域的组织第二大脑)。
一个程序层,将领域知识与分析方分开(配方)。
一个自动化评估套件,随每个改进周期增长。
人在回路的检查点,根据领域的风险承受能力进行校准。
更深层的原则很简单:将复杂性保持在文本文件中,这些文件对人类和 agent 都是可读的,而不是在微调的模型权重中。每次改进都是一个文件编辑,领域专家可以在 30 秒内审查。每次更改都是版本控制的、可 diff 的和可逆的。编译 pipeline 很复杂,但其输出始终是透明的。
目标是创建一个专家努力永久复合的系统。每次专家交互都使系统变得更好。每次纠正都作为经过验证的改进而持续。组织的集体知识不再被困在个人身上,开始可用的、一致的和大规模地提供给每个需要它的人。
致谢
作者要向以下人员的贡献表示感谢,他们在开发这个系统方面发挥了关键作用。特别感谢(按姓氏字母顺序):Cecilia Baek、Philipp Kaufold、Cat Hughes、Suzanne Leijten、Michael Marcusa、Jordi Mola、Timothy Neo、Elliott Prentiss、Laia Reyes、John Ross、Julio Santil、Taylor Wilson Thomas、Mansi Tripathi、Nikhil Shanbhag、Madeleine Vos 和 Jackie Zajac。