 林渡
本文来自一次真实的 ARM64 Android ramdump 分析。项目名、版本路径和人员信息已省略,文中的 物理地址只属于这一次现场,不能直接套到其他机器。
这个问题最初看起来很像一次普通的用户态连环崩溃:反复打开 Netflix 后,上层 service 开始报错, 最后内核因为 PID 1 退出而 panic。
[ 4218.798449] NE happened,fatal signal 11, si_code 1 (SEGV_MAPERR), si_addr 0
[ 4218.798482] PID: 1 Comm: init
[ 4219.191719] Kernel panic - not syncing: Attempted to kill init! exitcode=0x0000008b
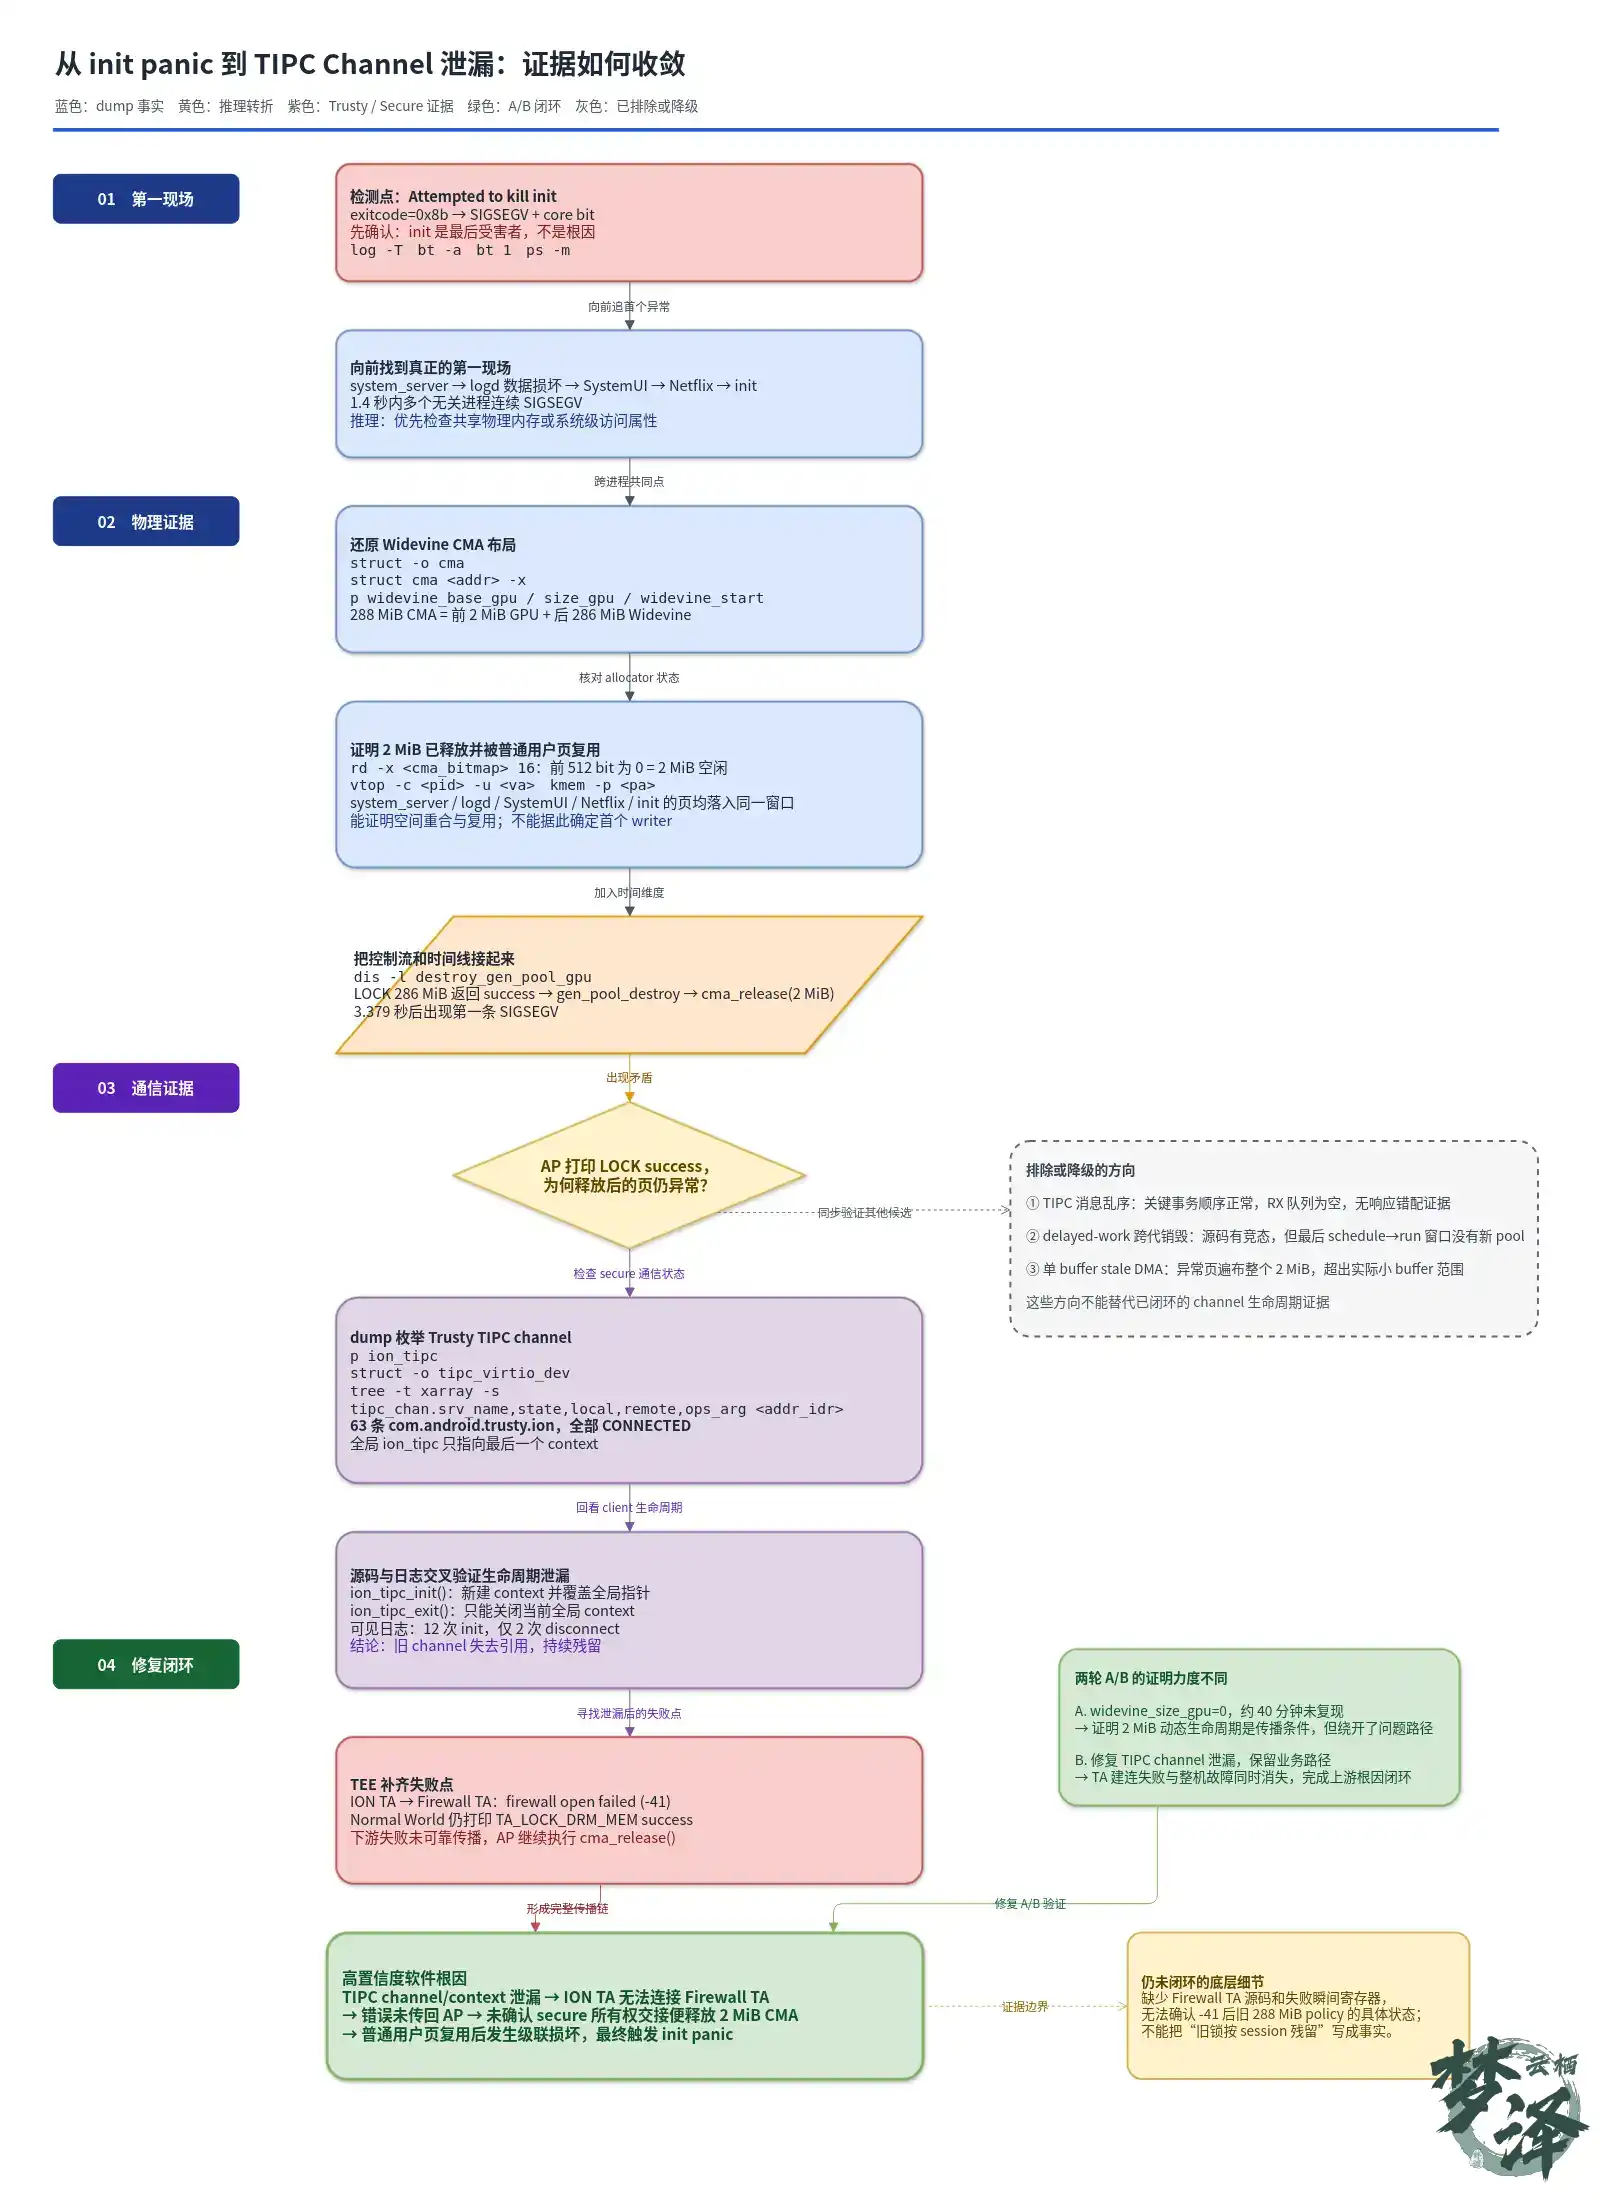
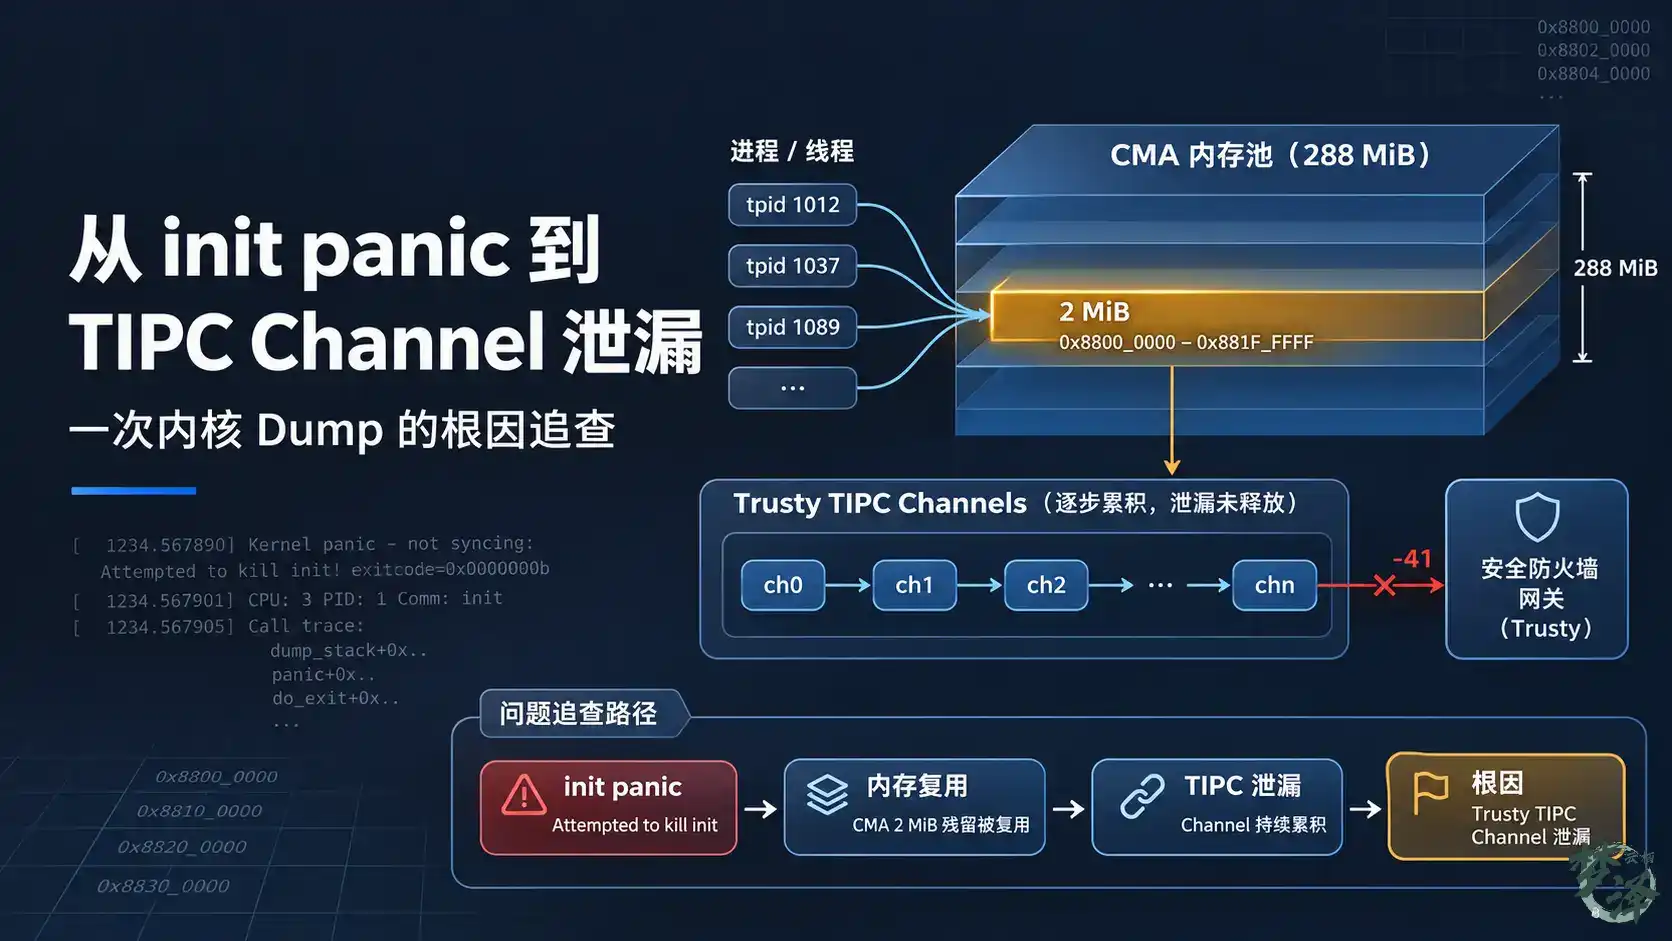
最终修掉的却不是 init、Netflix 或 CMA allocator,而是 Normal World 与 Trusty 通信时泄漏的 TIPC channel。泄漏积累后,ION TA 无法再连接 Firewall TA;错误又没有被完整传回 AP,AP 仍按 “防火墙更新成功”继续释放 2 MiB CMA。那 2 MiB 随后进入普通页分配器,被多个进程复用,最终把 system_server、logd、SystemUI、Netflix 和 init 一起拖垮。
这条链比较长。中间只要把某个“相关现象”提前当成根因,就很容易走偏。下面按实际分析顺序展开。
先别被 panic 文案带着走
我使用的是 crashctl 驱动的 crash 会话。普通 crash 用户可以直接执行代码块中引号里的 crash 命令;使用 crashctl 时,形式如下:
scripts/crashctl intake <ramdump目录> --vmlinux <vmlinux> --json
scripts/crashctl open <ramdump目录> --vmlinux <vmlinux> --json
scripts/crashctl run <sid> 'log -T' --json
打开 dump 后先做能力和现场探测:
sys config
log -T
bt -a
bt 1
ps -m
Attempted to kill init 的字面意思很吓人,但它通常只是 do_exit() 发现 global init 即将退出时 触发的保护性 panic。这里的 exitcode=0x8b 按 Linux wait status 解码:
0x8b & 0x7f = 11       -> SIGSEGV
0x8b & 0x80 != 0       -> 带 core-dump bit
也就是说,init 是因为 SIGSEGV 退出,并不是有人向它发了 SIGKILL,更不是 init 主动返回了某个 错误码。
继续向前翻日志,第一条 fatal signal 出现在 1.4 秒前:
4217.391214  system_server/PreventPreempti SIGSEGV
4217.391684  system_server/pre_starting SIGSEGV
4218.269375  logd 报 ZSTD 数据损坏
4218.270809  logd.writer SIGSEGV
4218.448293  SystemUI/AudioPortEventH SIGSEGV
4218.619153  Google Android AS/aiai-app-predic SIGSEGV
4218.704180  Netflix binder 线程 SIGSEGV
4218.798449  init SIGSEGV
4219.191719  Attempted to kill init panic
几个毫不相干的进程在 1.4 秒内一起崩溃,中间还夹着明确的 ZSTD 数据损坏。这时再盯着 init 的 调用栈意义不大,分析方向应该转向共享物理内存、系统级内存属性,或者某个能跨进程破坏页面的 master。
把 Widevine CMA 的物理布局还原出来
现场带有 vendor 模块,先加载匹配的模块符号。不要拿相邻版本的 .ko 凑数,结构和反汇编一旦 对不上,后面的地址计算看起来再工整也没有意义。
mod -S /path/to/matching/module/symbols接着检查目标版本的 struct cma 布局,再读取对应实例:
struct -o cma
struct cma ffffffc0851983c8 -x
关键字段是:
base_pfn       = 0xde800
count          = 0x12000 pages
available/free = 0x200 pages
目标内核使用 4 KiB page,因此:
CMA base = 0xde800 << 12 = 0xde800000
CMA size = 0x12000 << 12 = 0x12000000 = 288 MiB
CMA end  = 0xde800000 + 0x12000000 = 0xf0800000
运行时全局变量进一步给出了内部切分方式:
p widevine_size_gpu
p widevine_base_gpu
p widevine_size
p widevine_base
p widevine_start
p pool_alloc_size_gpu
p pool_gpu
读到的值是:
widevine_base_gpu = 0xde800000
widevine_size_gpu = 0x200000
widevine_start    = 512 pages
widevine_base     = 0xdea00000
widevine_size     = 0x11e00000
于是 288 MiB CMA 的布局就清楚了:
0xde800000                                      0xf0800000
    |---- GPU protected:2 MiB ----|---- Widevine:286 MiB ----|
                              0xdea00000
也就是:
[0xde800000, 0xdea00000)  GPU 子区间,2 MiB
[0xdea00000, 0xf0800000)  Widevine 区间,286 MiB
这里有一个容易混淆的点:这块物理内存既和 GPU protected buffer 有关,又通过 Trusty 命令更新 secure firewall,所以后面分析到 Trusty 并不是“从 GPU 跳到了另一个问题”,而是在追同一块物理 内存的所有权和访问策略。
bitmap 说这 2 MiB 已经释放了
struct cma 给出了 bitmap 地址,直接读前 16 个 64-bit word:
rd -x 0xffffff8081c60000 16现场的形态很整齐:
bitmap[0..7] = 0x0000000000000000
bitmap[8..]  = 0xffffffffffffffff
前 8 个 word 一共是 8 × 64 = 512 个 bit。每个 bit 对应一个 4 KiB page:
512 × 4 KiB = 2 MiB这正好等于 widevine_size_gpu。available_count=0x200 也等于 512 pages,两条证据相互吻合。
到这里能够确认的是:panic 时,CMA allocator 已经把最前面的 2 MiB 标成空闲。不能确认的是: secure firewall、GPU 或其他 master 是否也同步放弃了这段地址。CMA bitmap 只代表 Linux CMA 的 账本,不代表所有访问方的状态。
这些页去了哪里
下一步是把多个崩溃进程寄存器里的用户虚拟地址翻译成物理地址。用户地址必须绑定进程页表, 不能直接拿裸地址执行 vtop:
vtop -c 1690  -u 0x6af5048080
vtop -c 1690  -u 0x086bc6c8
vtop -c 467   -u 0x749da02160
vtop -c 2675  -u 0x70de80a1c0
vtop -c 3810  -u 0x4a01b958
vtop -c 3810  -u 0x6e27b07c70
vtop -c 13531 -u 0x6cb73a1080
vtop -c 1     -u 0x7f840dc000
结果出乎预料地集中:
这些物理页全部位于刚刚释放的 [0xde800000, 0xdea00000)。
再看代表页面的状态:
kmem -p 0xde9ec080
kmem -p 0xde9bf6c8
kmem -p 0xde95f080
kmem -p 0xde852000
页面已经带有普通用户页的 LRU、swap-backed 等属性,并不是“页还挂在 CMA allocation 名下,却 同时映射给用户进程”。更符合现场的解释是:CMA 合法释放了它们,伙伴系统又合法地把它们分配 给了不同用户进程。真正可疑的是,Linux 之外的访问策略是否完成了同样的所有权切换。
我也尝试过 page owner:
extend /path/to/pageowner.so
help pageowner
pageowner -s 0xde9ec000
但这次启动没有通过 page_owner=on 启用记录。编译了 CONFIG_PAGE_OWNER 不等于现场一定有分配 历史;功能没有在启动时打开,事后无法从 dump 补出调用栈。这个方向到此为止,不能硬猜。
还有一个边界需要说清楚:表里的用户地址来自异常时仍存活的寄存器或栈,它们不一定就是每次 SIGSEGV 的 si_addr。这组结果能证明多进程页面广泛复用了同一物理窗口,不能单独证明哪一页是 第一个 fault page,更不能指出第一个 writer。
释放发生在什么时刻
把日志按时间排好,物理区间切换和崩溃之间只隔了几秒:
4208.210825  GPU 从 CMA bitmap 0 分配 2 MiB,widevine_start=512
4208.256158  TA_LOCK_DRM_MEM(0xde800000, 288 MiB) success
4208.746074  最后一个 GPU buffer 释放,pool_alloc_size_gpu=0
4214.001710  delayed worker 开始销毁 GPU gen_pool
4214.012066  TA_LOCK_DRM_MEM(0xdea00000, 286 MiB) success
4217.391214  第一条 system_server SIGSEGV
通过模块反汇编核对实际运行的控制流:
dis -l destroy_gen_pool_gpu可以看到,较小范围的 TA_LOCK_DRM_MEM 返回后,代码继续执行:
gen_pool_destroy(pool_gpu)
cma_release(..., 2 MiB)
从 286 MiB LOCK 返回到第一条 SIGSEGV 是:
4217.391214 - 4214.012066 = 3.379148 秒从第一条 SIGSEGV 到 init SIGSEGV 是:
4218.798449 - 4217.391214 = 1.407235 秒时间、范围和受影响页面都对上了。不过“相关”还不是“根因”。当时仍有几个候选:旧 delayed work 销毁了新 pool、GPU stale DMA、secure firewall 没有更新,或者 TIPC 指令发生乱序。
一个很像根因、但现场没有命中的 delayed-work 竞态
源码里的 GPU 分配路径只在 delayed_work_pending() 为真时调用 cancel_delayed_work_sync()。如果 worker 已经开始执行,pending bit 可能已经清掉;而 destroy_gen_pool_gpu() 拿到锁后又没有复查 generation 和 pool_alloc_size_gpu。单看代码,确实 存在“上一轮 worker 销毁下一轮 pool”的可能。
我先从 dump 看 work 对象和 timer:
p &destroy_pool_work_gpu
struct delayed_work <destroy_pool_work_gpu地址>
timer -r
然后回到完整日志,检查最后一次 schedule 到 worker 真正执行之间,是否出现过新的 cma_create_gen_pool_gpu()。结果是:最后一次 GPU pool 创建发生在 4208.210796,最后一个 buffer 释放后于 4208.746117 安排销毁,worker 到 4214.001710 才运行,这个窗口里没有新一代 pool。
因此这段代码有缺陷,应该单独修,但本次没有“旧 worker 跨代销毁新 pool”的现场证据。把它留在 候选列表里没有问题,把它写成本次根因就过头了。
为什么开始检查 Trusty TIPC
TA_LOCK_DRM_MEM 不是普通的本地函数调用。Normal World 通过 ion_ipc_trusty 连接 com.android.trusty.ion,由 ION TA 再去操作 Firewall TA。只要这条链上有一段状态没有交接好, Linux 看到的“CMA 已释放”就可能和 secure world 的状态不一致。
先看当前 client context:
p ion_tipc
struct ion_tipc_ctx <ion_tipc地址>
再从 tipc_virtio_dev.addr_idr 的 xarray 枚举全部 channel。结构偏移必须以目标 vmlinux 为准:
struct -o tipc_virtio_dev
p &((struct tipc_virtio_dev *)0xffffff808ddc5400)->addr_idr
tree -t xarray -s tipc_chan.srv_name,state,local,remote,ops_arg \
    0xffffff808ddc54b0
dump 中一共留下了 63 条 com.android.trusty.ion channel,而且全部处于 TIPC_CONNECTED。local ID 从 1038 一直增长到 1101,全局 ion_tipc 却只指向最后一条对应的 context。
继续读取新旧 context:
struct ion_tipc_ctx 0xffffff80a459eb00
struct ion_tipc_ctx 0xffffff8082bfd400
旧 context 仍然是连接状态,channel 指针也没有清掉。回到源码再看,问题就比较直白了:
ion_tipc_init()
    -> 新建 context
    -> 覆盖全局 ion_tipc

ion_tipc_exit()
    -> 只能关闭当前全局 ion_tipc
而 CMA heap 的 firewall 更新路径每次都会重新 ion_tipc_init()。一旦旧指针被覆盖,后面再调用 exit 也只能关掉最新的一条,旧 channel 会一直留在 Trusty transport 中。
日志计数也支持这一点:当前可见窗口内有 12 次 init,只有 2 次 disconnect。dump 里的 63 条 CONNECTED channel 是更长时间积累后的结果,不像正常的短暂并发连接。
它是不是“消息乱序”
看到大量残留 channel 后,我一度怀疑过不同 session 的响应串了。但把两次关键事务的日志展开, 顺序是完整的:
ion_tipc_init
connect channel done
收到 greeting
write request
收到 response
TA_LOCK_DRM_MEM success
接收端用 list_add_tail(),读取端拿 list_first_entry(),发送侧也按队列提交。代码里确实还有 RX producer/consumer 未使用同一把锁的问题,协议也没有 request sequence/generation ID,但这次 dump 的 RX 队列为空,没有链表损坏或响应错配证据。
所以这里能下的结论是“channel/context 生命周期泄漏”,不能写成“TIPC transport 发生消息乱序”。 代码里存在另一个风险,不等于这个风险在本次现场已经发生。
TEE 日志补上了缺失的一段
问题场景的 TEE 日志末尾反复出现:
sprd-ion: firewall open failed!(-41)
sprd-ion: unable (-1) to handle request
sprd-ion: chan = 1063, out_buf_size = 24
sprd-ion: channel closed by peer
这里的 -41 是 ION TA 连接 Firewall TA 失败,不是 AP 连接 com.android.trusty.ion 失败。
奇怪的是,同一场景的 kernel log 中,TA_LOCK_DRM_MEM 和 TA_UNLOCK_DRM_MEM 仍然打印 success。 对照 Normal World 源码后可以解释这个矛盾:调用方只检查返回 payload 中的几个字段,同时忽略了 部分 ion_tipc_read()、ion_tipc_write() 返回值和准确长度。ION TA 下游连接 Firewall TA 的失败 没有被可靠地逐层传播,AP 仍按成功路径继续执行。
这时根因链已经能连起来:
反复切换 Widevine/GPU protected 场景
  -> ion_tipc_init() 反复创建新 channel,旧 context 丢失
  -> TIPC channel 持续泄漏
  -> ION TA 连接 Firewall TA 失败,返回 -41
  -> 下游错误没有可靠传播到 Normal World
  -> AP 误以为 286 MiB firewall 更新成功
  -> cma_release() 释放前 2 MiB
  -> 普通用户页复用这段物理内存
  -> 页面内容或访问属性异常
  -> 多个无关进程连续 SIGSEGV
  -> init 死亡,触发 Attempted to kill init
最后两步中的底层硬件细节仍然缺证据。我们没有 Firewall TA 源码,也没有失败瞬间的 firewall 寄存器,无法确认旧 288 MiB policy 是继续保留、部分更新,还是出现了其他 secure master 访问。 因此可以确认的是“未完成可靠交接便释放 CMA”,不能把“旧锁一定按 session 残留”写成既成事实。
两轮 A/B 各自证明了什么
第一轮实验把 widevine_size_gpu 从 2 MiB 改为 0。按原场景压力约 40 分钟,没有再复现,TEE 日志里也没有出现相同的 firewall 错误。
这个结果说明 GPU 2 MiB 的动态分配、firewall 切换和释放是故障传播所需的条件。但它绕开了整条 问题路径,不能单独证明是 firewall 残留,更不能作为最终修复。
第二轮修复的是 TIPC channel 泄漏,保留了 GPU protected 的业务路径。修复后 ION TA 到 Firewall TA 的建连失败消失,原场景也不再复现。这组 A/B 的区分度更高:它直接改变了上游错误状态,同时 保留了后面的 CMA 使用方式,因此足以把 TIPC 生命周期泄漏提升为高置信度的软件根因。
完整的量产结论仍需要补齐修复版本、设备数、循环次数、压力时长和 channel 峰值。一次“不再 复现”可以闭环工程判断,但不能替代失败率数据。
最终修复和仍应保留的防线
已经落地的修复是消除 TIPC channel 生命周期泄漏,使重复切换时的连接能够复用或成对销毁, 不再因为旧 context 被覆盖而遗留大量 CONNECTED channel。
这能解决当前根因,但内存所有权交接代码还应该有几道防线:
tipc_chan_connect()、read、write 和响应长度必须全部校验,不能只看 payload 里的 success;ION TA 到 Firewall TA 的真实错误应逐层返回 AP;
secure update 最好有明确的 UPDATE/REPLACE 语义和 generation ID;
任意通信或策略更新失败时 fail closed,保留或隔离 backing,禁止
cma_release();delayed work 执行前重新检查 generation、pool 指针和当前引用数,避免跨代销毁;
如果业务允许,2 MiB 可以长期 pin 在 CMA,或者拆成独立、非 reusable 的 reserved-memory, 但后者需要同步调整 heap、偏移和 CPU 映射,不能简单建立重叠 reserved-memory 节点。
“把 2 MiB 永久留住”是有效的隔离措施,却不是 TIPC 泄漏的修复。它避免坏状态传播到普通用户页, 但不会让泄漏的 channel 自动消失。这两个层次需要分开。
这次分析里最有用的几个提醒
Attempted to kill init 往往是终点,不是起点。先解码 exitcode,再向前找第一条异常,比围着 panic 栈看半天更有用。
CMA bitmap 只能回答 Linux allocator 怎么记账。涉及 GPU、DMA 或 secure world 时,释放物理页 之前还要确认所有访问方都完成了权限和所有权切换。
vtop 命中同一物理窗口是很强的空间证据,但不是 writer 证据。寄存器指向某页,也不等于该页 就是这次 SIGSEGV 的 fault page。把“能证明什么”和“还不能证明什么”写清楚,反而更容易让后续 实验真正击中缺口。
最后,源码里看见一个竞态、日志里看见一个错误、dump 里看见一堆残留对象,都还不等于根因。 这次真正让结论站稳的是三类证据碰到了一起:dump 还原了 2 MiB 的释放和复用,源码解释了 TIPC 泄漏机制,修复泄漏后的 A/B 又让 TA 建连失败和整机故障同时消失。单独看任何一类,都没有这么 强。